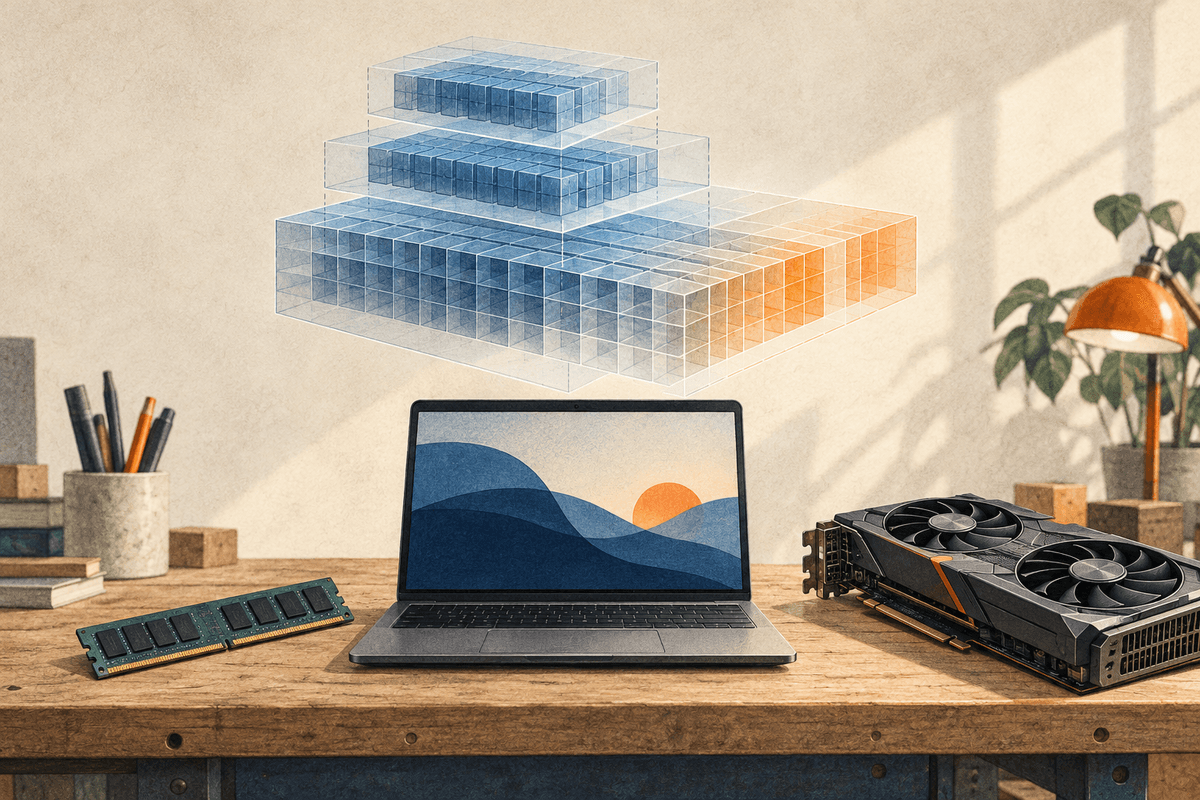
รันโมเดลภาษาในเครื่อง ต้องเผื่อหน่วยความจำให้บทสนทนาด้วย
ประเมินหน่วยความจำจากน้ำหนักโมเดล แคช KV และความยาวบริบท พร้อมตรวจผลของการควอนไทซ์และการแบ่งงานระหว่างซีพียูกับจีพียู
คุณกำลังเตรียมผู้ช่วยในเครื่องไว้อ่านรายงานยาว ก่อนดาวน์โหลดจึงลองเทียบขนาดไฟล์โมเดลกับหน่วยความจำที่เหลืออยู่ แต่ตอนทำงานจริง ข้อความที่อ่านก็ต้องใช้พื้นที่ด้วย การอนุมานยังมีสถานะจากการคำนวณความสนใจและพื้นที่ทำงานเพิ่มเติมนอกเหนือจากน้ำหนักของโมเดล12
ทดสอบให้ถึงขั้นตอบคำถามจากรายงานจนจบเพื่อดูว่าความจุพอหรือไม่ บทความนี้อธิบายรายการที่ต้องเผื่อจากเอกสารทางการ ไม่มีผลทดสอบคอมพิวเตอร์เฉพาะรุ่น และไม่จัดอันดับอุปกรณ์ตามจำนวนพารามิเตอร์
เริ่มจากงานที่อยากทำให้เสร็จ
เลือกรายงานตัวอย่างพร้อมคำสั่งที่ต้องการใช้ รวมประวัติสนทนาที่จำเป็น และเผื่อที่ให้คำตอบด้วย โทเคนที่ประมวลผลแล้วมีส่วนในสถานะที่เก็บระหว่างการสร้างข้อความ การนับเฉพาะเนื้อหารายงานจึงยังไม่ครอบคลุมบริบททั้งหมดของงาน13
ถ้าใช้ Ollama คำสั่ง ollama ps แสดงบริบทที่จัดสรรและการแบ่งระหว่างซีพียูกับจีพียูได้ เวลาทดลองเปรียบเทียบ ให้กำหนดความยาวบริบทเอง เอกสาร FAQ กับคู่มือบริบทในปัจจุบันอธิบายค่าเริ่มต้นต่างกัน การจดค่าที่ใช้งานจริงช่วยให้ทดลองซ้ำได้ตรงกว่า43
กำหนดเกณฑ์คำตอบจากงานนั้น เช่น ต้องดึงรายละเอียดที่ตรวจสอบกับต้นฉบับได้ และใช้รูปแบบที่กำหนดไว้ เกณฑ์เหล่านี้เป็นข้อเสนอสำหรับการประเมิน ไม่ใช่คะแนนความแม่นยำที่บทความวัดมาแล้ว
น้ำหนักโมเดลเป็นเพียงรายการแรก
น้ำหนักเก็บพารามิเตอร์ที่ได้จากการฝึก การควอนไทซ์ลดความละเอียดในการเก็บตัวเลขเพื่อลดหน่วยความจำ โดยพยายามรักษาความแม่นยำไว้ ดังนั้นจำนวนพารามิเตอร์ต้องดูคู่กับรูปแบบและไฟล์ที่เลือกใช้ จึงจะช่วยประมาณพื้นที่ได้5
เฉพาะน้ำหนัก อาจประมาณไบต์จากจำนวนพารามิเตอร์คูณจำนวนบิตต่อน้ำหนัก แล้วหารด้วยแปด ภายใต้สมมติฐานว่าทุกตัวใช้ความละเอียดเดียวกันและจัดเก็บอย่างแน่นหนา วิธีจริงอาจมีค่าคงที่สำหรับการควอนไทซ์ รวมถึงโมดูลที่ยังใช้ความละเอียดอื่น จึงต้องตรวจไฟล์และรายงานของโปรแกรมเพิ่ม สูตรนี้ยังไม่รวมแคช56
สำหรับการวางแผน ให้แยกน้ำหนักที่อยู่ในหน่วยความจำ แคช KV พื้นที่คำนวณชั่วคราว และการจัดสรรของระบบรัน โปรแกรมอื่นต้องมีพื้นที่ของตนเองด้วย การแยกเช่นนี้เป็นกรอบประมาณการ ไม่ใช่สูตรตายตัว เพราะวิธีโหลดและตำแหน่งข้อมูลเปลี่ยนทั้งปริมาณที่ใช้และช่วงที่ใช้สูงสุด172
แคช KV เก็บผลคำนวณจากข้อความที่ประมวลผลแล้ว
Transformer แบบสร้างข้อความทีละโทเคนใช้บริบทก่อนหน้าเพื่อคำนวณโทเคนถัดไป แคช KV เก็บคีย์และค่าจากชั้นความสนใจของโทเคนที่ประมวลผลแล้ว เพื่อนำผลคำนวณกลับมาใช้ ส่วนนี้เป็นสถานะของคำขอ แยกจากน้ำหนักที่เรียนรู้ระหว่างการฝึก1
แคชแบบไดนามิกขยายระหว่างสร้างคำตอบ ส่วนแคชแบบคงที่จองความจุสูงสุดไว้ล่วงหน้า จึงอาจมีพื้นที่จองมากแม้บทสนทนายังสั้น ชั้นที่ใช้หน้าต่างเลื่อนหรือแบ่งความสนใจเป็นช่วงมีขอบเขตการขยายตามกลไกนั้น การนำพฤติกรรมของโมเดลหนึ่งไปใช้คาดเดาอีกสถาปัตยกรรมจึงต้องระวัง8
การประมาณแคชสำหรับความสนใจแบบเต็มตามปกติต้องพิจารณาโทเคนที่เก็บ ลำดับข้อความที่ทำพร้อมกัน จำนวนชั้น จำนวนหัว KV ขนาดของแต่ละหัว และความละเอียดแคช จำนวนพารามิเตอร์ไม่ได้กำหนดทุกเงื่อนไขเหล่านี้ หากต้องการดูผลจากความยาว ให้คงโมเดลและความละเอียดไว้เหมือนเดิม18
บริบทยาวกับงานพร้อมกันต้องวางแผนร่วมกัน
Ollama อธิบายว่าบริบทที่ยาวขึ้นใช้หน่วยความจำเพิ่ม และการประมวลผลหลายคำขอพร้อมกันในโมเดลเดียวก็เพิ่มการจัดสรรบริบท คำขอหลายรายการใช้น้ำหนักโมเดลร่วมกันได้ แต่แต่ละคำขอที่กำลังประมวลผลยังต้องมีพื้นที่เก็บสถานะของตัวเอง การนำขนาดไฟล์คูณจำนวนผู้ใช้จึงไม่อธิบายการใช้พื้นที่ส่วนนี้ได้ครบ43
เริ่มทดสอบส่วนตัวด้วยคำขอที่ทำต่อกันก่อน หากจะให้หลายคนใช้ ค่อยทดลองงานยาวที่เกิดทับซ้อนกัน แยกคำขอที่กำลังทำออกจากคำขอที่รอคิว Ollama มีการตั้งค่าสำหรับการทำงานขนานและคิวรอแยกกัน4
ผลจากงานสั้นเพียงงานเดียวจึงไม่ควรนำไปสัญญาความจุของบริการที่มีงานยาวซ้อนกัน ให้ใช้คำขอตัวแทนงานจริงในระดับการทำงานพร้อมกันที่ตั้งใจไว้ แล้วบันทึกการจัดสรรที่เกิดขึ้น4
ลดความละเอียดน้ำหนักแล้ว ต้องดูแคชแยกอีกครั้ง
ชื่อไฟล์น้ำหนักที่ควอนไทซ์แล้วไม่ได้กำหนดความละเอียดของแคช KV โดยอัตโนมัติ llama.cpp มีตัวเลือกชนิดแคชคีย์และค่าแยกกัน ส่วน Ollama ก็มีตัวเลือกควอนไทซ์แคชของตนเอง ตรวจความสามารถของระบบที่ใช้อยู่ก่อนเปลี่ยนการตั้งค่า49
Ollama ระบุว่าผลต่อคุณภาพขึ้นกับโมเดลและงาน ให้ใช้รายงานเดิมกับคำสั่งเดิม เปลี่ยนความละเอียดครั้งละรายการ แล้วตรวจว่ารายละเอียดสำคัญตกหล่นหรือรูปแบบคำตอบผิดหรือไม่ พร้อมดูพื้นที่ที่ประหยัดได้ จะตีความความเปลี่ยนแปลงได้ง่ายกว่าการเปลี่ยนหลายอย่างพร้อมกัน4
การลดแคชไม่ได้รับประกันว่าจะตอบเร็วขึ้น เอกสาร Transformers เตือนว่าเมื่อบริบทสั้นและหน่วยความจำจีพียูเพียงพออยู่แล้ว การควอนไทซ์แคชอาจเพิ่มความหน่วง ควรใช้เพื่อแก้ข้อจำกัดที่ตรวจพบ แล้ววัดงานเดิมอีกครั้ง8
ตัวเลขที่จองไว้ซ้อนอยู่กับตัวเลขที่ใช้จริง
ใน PyTorch ที่ใช้ CUDA ฟังก์ชัน memory_allocated() ติดตามหน่วยความจำของเทนเซอร์ ส่วน memory_reserved() ติดตามพื้นที่ทั้งหมดที่ตัวจัดสรรแคชดูแล และมีตัวนับค่าสูงสุดของแต่ละประเภท พื้นที่จองที่ยังไม่ได้ใช้ก็อาจแสดงว่าใช้อยู่ใน nvidia-smi7
ตัวเลขสองชุดนี้มีส่วนที่ซ้อนกัน จึงไม่ควรบวกเป็นภาระคนละก้อน คำสั่ง empty_cache() คืนบล็อกแคชที่ไม่ได้ใช้ แต่เทนเซอร์ที่ยังทำงานอยู่จะคงอยู่ น้ำหนักและแคช KV ที่ยังจำเป็นไม่ได้หายไปจากการเรียกคำสั่งนี้7
ฟังก์ชันดังกล่าวเป็นของ PyTorch ถ้าใช้ llama.cpp ต้องดูรายงานของระบบนั้นเอง เผื่อพื้นที่สำหรับการเริ่มทำงานและคำนวณจากสิ่งที่สังเกตได้ แทนการเพิ่มเปอร์เซ็นต์เดียวให้ทุกโปรแกรมโดยไม่มีข้อมูลรองรับ92
แบ่งไปซีพียูแล้วต้องจับเวลาจนจบ
llama.cpp จำกัดจำนวนชั้นที่จะเก็บใน VRAM ได้ ส่วนการย้ายแคชของ Transformers เก็บแคชของชั้นส่วนใหญ่ไว้ทางซีพียู แล้วส่งกลับเมื่อต้องใช้ สองวิธีนี้ย้ายวัตถุคนละอย่าง จึงควรบันทึกให้ชัดว่าเปลี่ยนตำแหน่งน้ำหนักหรือแคช89
ต้องประมาณ RAM ระบบกับ VRAM เฉพาะแยกกัน การย้ายแคชอาจลดอัตราการสร้างข้อความเพราะมีการถ่ายโอนข้อมูล เอกสารไม่ได้ให้ตัวคูณความช้าที่ใช้ได้กับคอมพิวเตอร์ทุกเครื่อง ให้ดูเวลาที่งานตัวอย่างเสร็จเพื่อพิจารณาว่ารับได้หรือไม่82
| อาการที่สังเกต | จุดที่ควรตรวจ | การเปรียบเทียบถัดไป |
|---|---|---|
| ล้มเหลวตอนโหลด | น้ำหนัก ตำแหน่งข้อมูล และค่าสูงสุดช่วงโหลด2 | ใช้ไฟล์เล็กลงโดยคงค่าอื่น |
| ล้มเหลวเมื่อส่งรายงานยาว | บริบทที่จัดสรรและแคช KV83 | ลดบริบทโดยใช้โมเดลเดิม |
| ล้มเหลวเมื่อคำขอซ้อนกัน | การจัดสรรสำหรับงานขนาน4 | ทำคำขอเดิมต่อกัน |
| ตอบจบแต่จีพียูยังใช้พื้นที่มาก | เทนเซอร์และพื้นที่จองของ PyTorch7 | เทียบ allocated กับ reserved |
| ย้ายไปซีพียูแล้วรอนาน | การถ่ายโอนและการประมวลผล82 | เปลี่ยนเฉพาะการวางข้อมูล |
ตารางเป็นจุดเริ่มตรวจสอบ ยังไม่ได้ยืนยันสาเหตุ เก็บรุ่นของไฟล์โมเดลและโปรแกรม ความยาวบริบท ความละเอียดแคช การวางข้อมูล และจำนวนคำขอที่ทำพร้อมกัน สังเกตทั้งการโหลด การประมวลผลข้อความเข้า และการสร้างคำตอบ เพราะแต่ละช่วงมีการจัดสรรต่างกัน12
เมื่อได้ค่าที่เหมาะสม ให้เก็บรายงานตัวอย่างนั้นไว้ใช้หลังอัปเดตโปรแกรมหรือเปลี่ยนโมเดล การทำงานเดิมซ้ำจะช่วยเทียบได้ว่าคำตอบยังใช้ได้และเวลารอยังเหมาะกับงานของคุณหรือไม่
แหล่งอ้างอิง
Footnotes
-
Hugging Face Transformers — ต้นฉบับภาษาอังกฤษอธิบายแคช KV และมิติเทนเซอร์: https://huggingface.co/docs/transformers/en/cache_explanation ↩ ↩2 ↩3 ↩4 ↩5 ↩6
-
Hugging Face Accelerate — การโหลด การกระจายอุปกรณ์และพื้นที่ทำงาน ต้นฉบับอังกฤษ: https://huggingface.co/docs/accelerate/en/concept_guides/big_model_inference ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7
-
Ollama — คู่มือภาษาอังกฤษเรื่องบริบทและการตรวจพื้นที่ที่จัดสรร: https://docs.ollama.com/context-length ↩ ↩2 ↩3 ↩4
-
Ollama FAQ — งานพร้อมกัน คิว การวางข้อมูลและการควอนไทซ์แคช ต้นฉบับอังกฤษ: https://docs.ollama.com/faq ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7
-
Hugging Face Transformers — เอกสารทางการภาษาอังกฤษเรื่องการควอนไทซ์และความแม่นยำ: https://huggingface.co/docs/transformers/en/quantization/overview ↩ ↩2
-
Hugging Face bitsandbytes — ค่าคงที่ควอนไทซ์และความละเอียดโมดูล ต้นฉบับภาษาอังกฤษ: https://huggingface.co/docs/transformers/en/quantization/bitsandbytes ↩
-
PyTorch CUDA — เทนเซอร์ พื้นที่จอง ค่าสูงสุดและการคืนแคช เอกสารภาษาอังกฤษ: https://docs.pytorch.org/docs/2.14/notes/cuda.html ↩ ↩2 ↩3 ↩4
-
Hugging Face Transformers — แคชแบบต่าง ๆ การควอนไทซ์และการย้ายไปซีพียู เอกสารภาษาอังกฤษ: https://huggingface.co/docs/transformers/en/kv_cache ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7
-
llama.cpp server — ตัวเลือกทางการสำหรับชั้นจีพียูและชนิดแคชคีย์กับค่า: https://github.com/ggml-org/llama.cpp/blob/master/tools/server/README.md ↩ ↩2 ↩3
ส่วนขยายขออ่านทุกเว็บไซต์ ควรให้สิทธิ์แค่ไหน
ตรวจสิทธิ์เข้าถึงเว็บไซต์ของส่วนขยายใน Chrome, Edge และ Firefox รวมถึงผู้พัฒนา การใช้งานในโหมดส่วนตัว และการซิงค์ส่วนขยาย
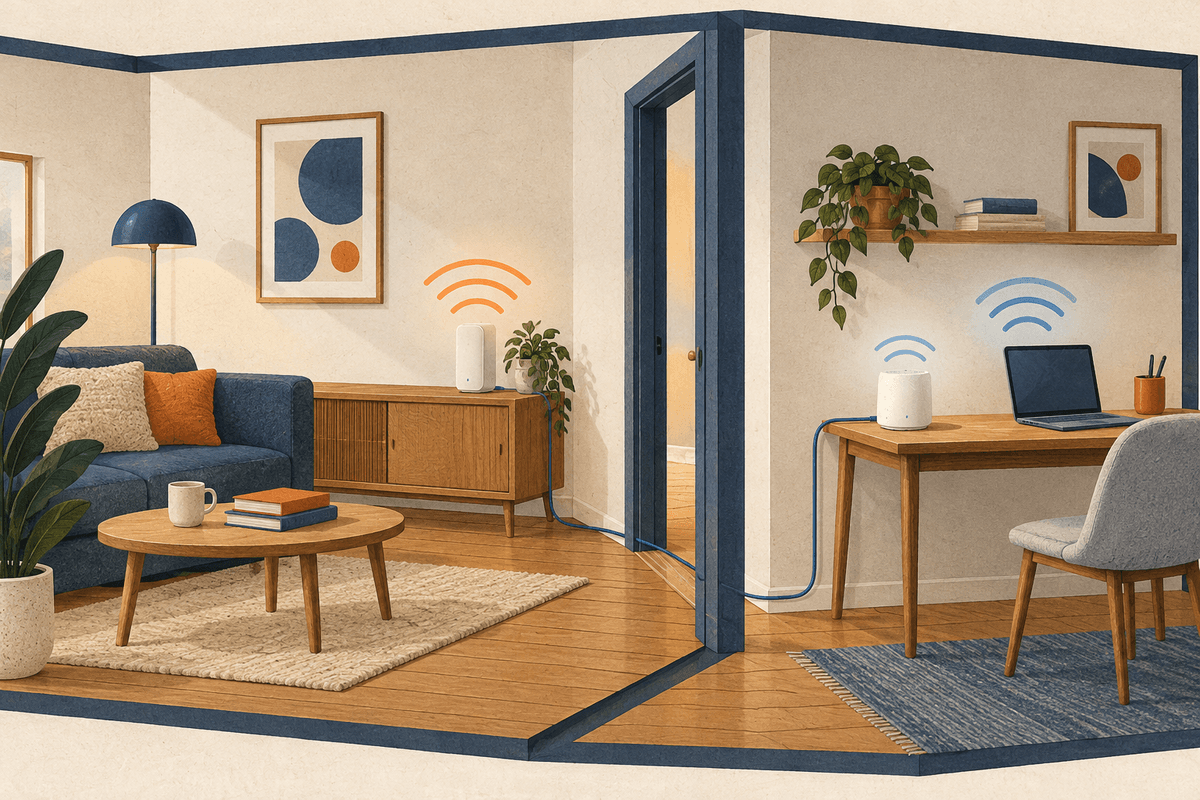
ไวไฟเมชสัญญาณเต็มแต่ยังช้า ลองตรวจทางเชื่อมระหว่างจุดกระจายสัญญาณ
เปรียบเทียบความเร็วผ่านสายและไวไฟด้วยเครื่องเดียวกัน แล้วตรวจการเชื่อมต่อกับตำแหน่งวางจุดกระจายสัญญาณ
AI อ้าง PDF ของคุณ ตรวจอย่างไรว่าต้นฉบับรองรับคำตอบจริง
วิธีเทียบคำตอบ AI กับ PDF ต้นฉบับ ตั้งแต่เลขหน้าและข้อความจาก OCR ไปจนถึงคำอ้างและตัวเลขในตาราง พร้อมวิธีรับมือเมื่อแหล่งอ้างอิงไม่ตรง
ติดตามบทความภาษาไทย
คัดลอกที่อยู่ด้านล่างไปเพิ่มในแอปอ่าน RSS ที่ใช้
ฟีดนี้มีเฉพาะบทความภาษาไทย