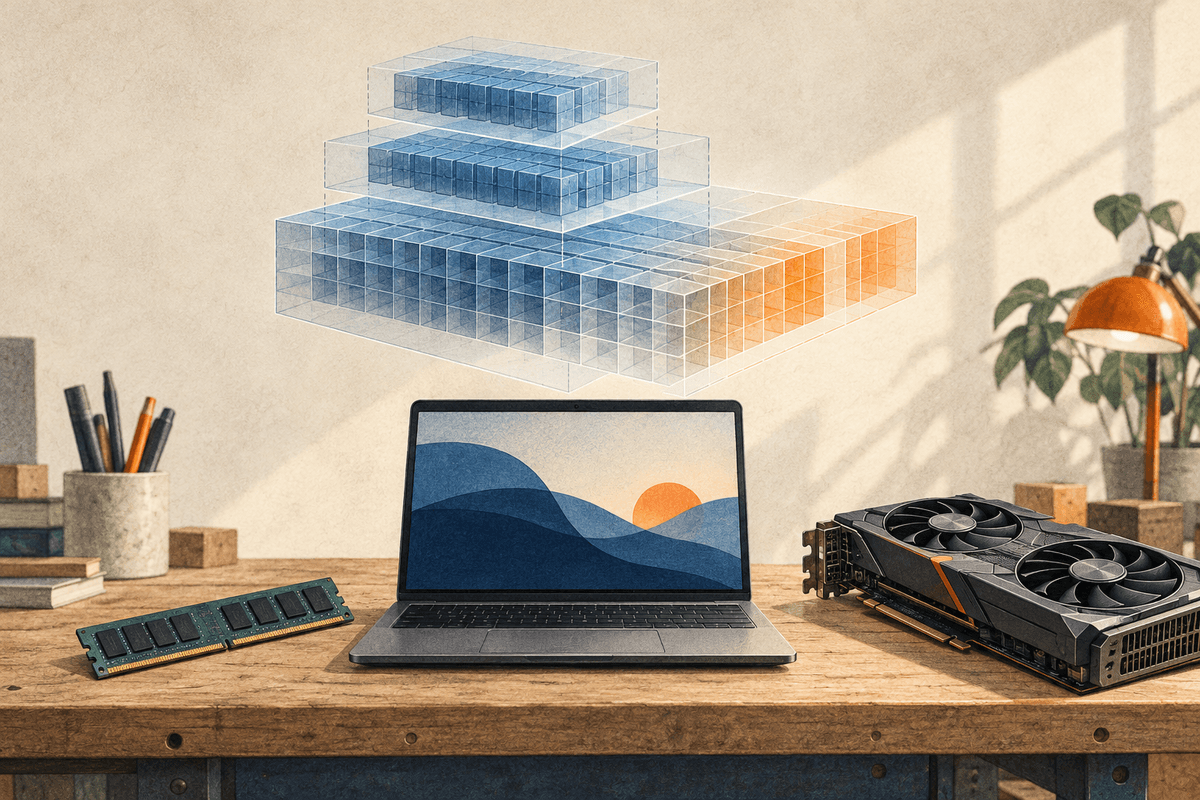
IA locale : prévoir de la mémoire pour le document et sa réponse
Estimez la mémoire nécessaire aux poids du modèle, au cache KV et aux requêtes simultanées, puis vérifiez-la avec vos documents.
Vous préparez un assistant local pour relire un dossier. Avant de télécharger le modèle, vous comparez son fichier avec la mémoire disponible. Il faut aussi prévoir la place du dossier : pendant l’inférence, des états d’attention et des allocations de travail s’ajoutent aux poids. Agrandir le contexte demande davantage de mémoire.123
La vérification utile va donc jusqu’à la réponse terminée, avec vos applications habituelles ouvertes. Les explications suivantes viennent de documents officiels. Elles ne constituent pas un essai de matériel, et les estimations ne promettent pas une capacité identique sur toutes les machines.
Définir le travail avant la capacité
Commencez par garder un document représentatif et les consignes que vous voulez lui appliquer. Incluez l’historique nécessaire et la place prévue pour la réponse. Le cache conserve des informations sur les tokens traités ; une entrée longue et la continuation produite participent donc au besoin de mémoire.1
Dans Ollama, vérifiez le contexte alloué et la répartition CPU/GPU avec ollama ps. Fixez explicitement la longueur pour comparer deux configurations. La FAQ et le guide du contexte présentent actuellement des valeurs par défaut différentes : le réglage observé sera une référence plus reproductible.42
Cette étape permet de poser une exigence concrète : traiter ce dossier avec un résultat vérifiable et un délai acceptable. Elle évite de prendre le simple chargement du modèle pour la validation de toute la tâche.
Les poids donnent une première estimation
Les poids contiennent les paramètres appris. La quantification utilise une représentation moins précise pour réduire leur encombrement, en essayant de préserver l’exactitude. Le nombre de paramètres doit donc être accompagné du format et du fichier retenus.5
Pour les poids seuls, « paramètres × bits par poids ÷ huit » donne une estimation en octets, à condition de supposer une précision uniforme et un stockage compact. Des constantes de quantification et des modules conservés à une autre précision limitent cette approximation. Elle exclut le cache et les espaces de travail.56
Pour préparer le budget complet, distinguez poids résidents, cache KV, mémoire temporaire de calcul et allocations de l’environnement d’exécution. Ajoutez les autres applications séparément. Ce découpage sert à réfléchir, pas à appliquer une formule universelle : la répartition entre appareils et la méthode de chargement modifient les besoins et leurs pics.173
Le cache KV dépend du texte et de l’architecture
Un Transformer autorégressif réutilise le contexte précédent pour produire le token suivant. Le cache KV conserve les clés et les valeurs d’attention des tokens déjà traités. Il évite de refaire ces calculs et représente un état propre à la requête, distinct des paramètres du modèle.1
Avec un cache dynamique, l’occupation augmente pendant la génération. Un cache statique réserve d’avance une capacité maximale. Certaines couches à fenêtre glissante ou à attention par blocs plafonnent leur cache selon leur propre mécanisme. On ne peut donc pas extrapoler automatiquement le comportement d’une architecture à une autre.8
Une estimation classique pour de l’attention complète dépend des tokens conservés, des séquences simultanées, des couches, des têtes KV, de leurs dimensions et de la précision du cache. Le nombre de paramètres ne décrit pas cet ensemble. Pour isoler l’effet de la longueur, gardez le modèle et la précision inchangés.18
Lire les chiffres de mémoire sans les additionner deux fois
PyTorch distingue la mémoire des tenseurs actifs de celle que son allocateur de cache gère au total. Les fonctions memory_allocated() et memory_reserved() suivent ces catégories, avec des variantes pour les pics. Une réserve inutilisée peut toujours apparaître occupée dans nvidia-smi.7
Les deux chiffres se recouvrent. Les additionner gonflerait le budget. empty_cache() rend les blocs de cache inutilisés disponibles, mais les tenseurs encore actifs restent en mémoire. Les poids et le cache de la requête ne disparaissent pas grâce à cet appel.7
Ces fonctions concernent PyTorch. Avec llama.cpp, utilisez ses rapports et ses réglages. Prévoyez une marge observée pour l’initialisation et le calcul plutôt qu’un pourcentage fixe supposé valable pour tous les logiciels.93
Régler séparément précision et demandes simultanées
Un fichier de poids quantifié ne détermine pas le type du cache KV. llama.cpp expose des réglages distincts pour les clés et les valeurs ; Ollama documente également la quantification de son cache. Vérifiez les possibilités de votre version et de votre moteur.49
Il faut aussi contrôler la qualité. Ollama indique que l’effet du cache quantifié dépend du modèle et du travail demandé. Comparez, sur le même dossier, les détails extraits et le respect du format attendu. Ne changez qu’un réglage de précision à la fois. Transformers prévient aussi que quantifier le cache peut augmenter la latence sur des contextes courts si la mémoire GPU suffit déjà.84
La concurrence constitue un autre réglage. Ollama augmente l’allocation de contexte quand un modèle traite des requêtes en parallèle. Les poids partagés et les états des requêtes ont des rôles différents. Une multiplication du fichier par le nombre d’utilisateurs ne décrit pas ces allocations.4
Pour un usage individuel, validez d’abord le dossier en traitement séquentiel. Pour partager l’assistant, reproduisez ensuite des demandes longues qui se chevauchent. Distinguez les requêtes actives de la file d’attente, que le serveur contrôle séparément.4
Déplacer vers le CPU impose une nouvelle mesure
llama.cpp permet de limiter les couches stockées en VRAM. Dans Transformers, le déchargement du cache conserve la plupart des caches de couches sur le CPU et les transfère au besoin. Notez précisément ce qui est déplacé : poids et cache sont deux objets différents.89
Établissez des budgets séparés pour la RAM système et la VRAM dédiée. Le déchargement du cache peut réduire le débit de génération à cause des transferts. Le délai dépend de la configuration ; aucune pénalité chiffrée universelle ne remplace un essai avec votre dossier.83
| Moment du problème | Piste à examiner | Comparaison proposée |
|---|---|---|
| Pendant le chargement | Poids, placement, pic de chargement3 | Fichier plus petit, autres réglages identiques |
| Avec un dossier plus long | Contexte alloué et cache KV82 | Contexte plus court, même modèle |
| Avec des demandes simultanées | Allocation du traitement parallèle4 | Mêmes demandes exécutées successivement |
| Après la réponse, occupation GPU élevée | Tenseurs actifs ou réserve PyTorch7 | Comparer allocated et reserved |
| Après déplacement vers le CPU, délai excessif | Transferts et exécution83 | Modifier seulement le placement |
Le tableau propose des hypothèses, à vérifier dans les rapports. Pour chaque observation, notez la version du modèle et du moteur, la longueur du contexte, le type du cache, le placement et le nombre de requêtes actives. Surveillez le chargement, le traitement du texte et la génération : leurs allocations diffèrent.13
Gardez ensuite ce dossier pour les mises à jour. Refaire la même tâche permettra de juger le nouveau réglage sur la qualité de la réponse et sur le temps que votre travail autorise.
Sources
Footnotes
-
Hugging Face Transformers — Explication originale anglaise du cache KV et des dimensions : https://huggingface.co/docs/transformers/en/cache_explanation ↩ ↩2 ↩3 ↩4 ↩5 ↩6
-
Ollama — Contexte alloué, consommation et inspection ; guide officiel anglais : https://docs.ollama.com/context-length ↩ ↩2 ↩3
-
Hugging Face Accelerate — Chargement, placement et mémoire de travail ; original anglais : https://huggingface.co/docs/accelerate/en/concept_guides/big_model_inference ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7
-
Ollama FAQ — Concurrence, attente, placement et cache quantifié ; original anglais : https://docs.ollama.com/faq ↩ ↩2 ↩3 ↩4 ↩5 ↩6
-
Hugging Face Transformers — Documentation officielle anglaise sur la quantification et l’exactitude : https://huggingface.co/docs/transformers/en/quantization/overview ↩ ↩2
-
Hugging Face bitsandbytes — Constantes de quantification et précision des modules ; original anglais : https://huggingface.co/docs/transformers/en/quantization/bitsandbytes ↩
-
PyTorch CUDA — Allocations, réserves, pics et libération du cache ; documentation anglaise : https://docs.pytorch.org/docs/2.14/notes/cuda.html ↩ ↩2 ↩3 ↩4
-
Hugging Face Transformers — Caches dynamique, statique, quantifié et déchargé ; original anglais : https://huggingface.co/docs/transformers/en/kv_cache ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7
-
llama.cpp server — Réglages officiels des couches GPU et des types de cache : https://github.com/ggml-org/llama.cpp/blob/master/tools/server/README.md ↩ ↩2 ↩3
Limiter les sites accessibles à une extension de navigateur
Vérifiez les accès d’une extension dans Chrome, Edge et Firefox, ses autorisations en navigation privée et ses réglages de synchronisation.
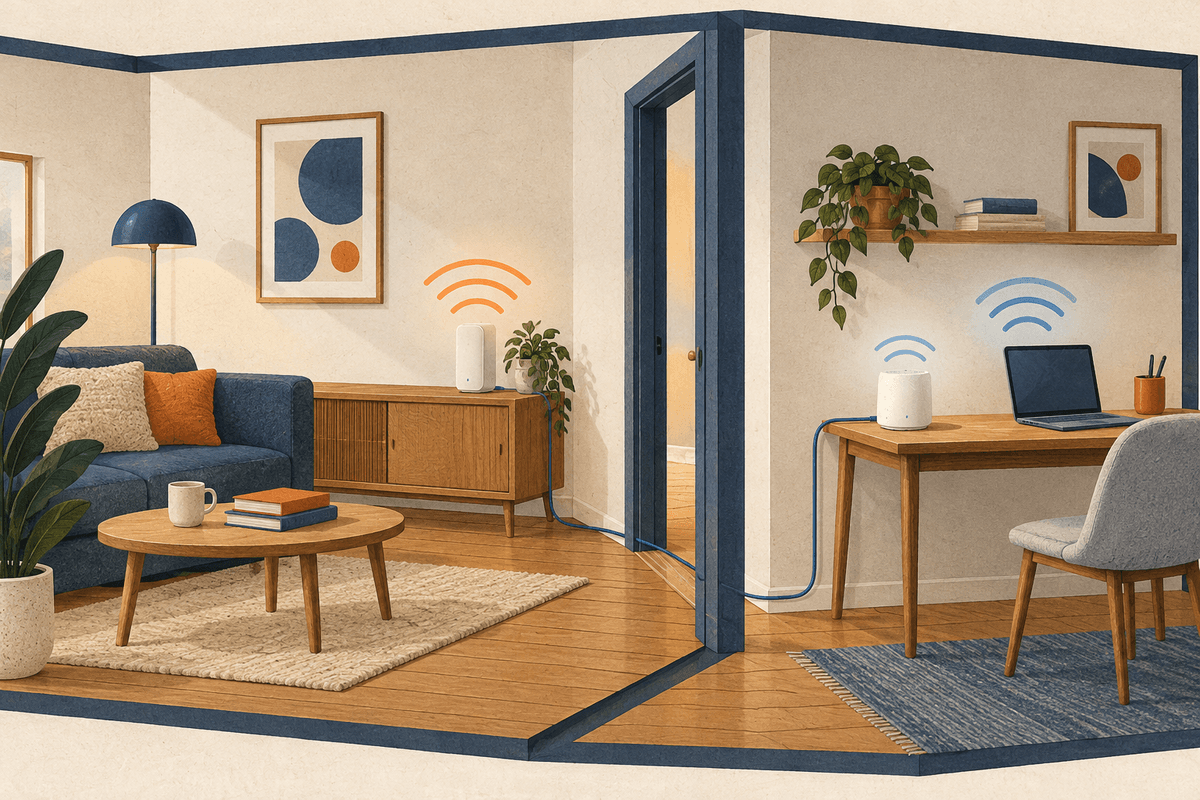
Wi-Fi maillé lent : tester la liaison entre les bornes
Comparez le débit au routeur et près des bornes, puis vérifiez leur liaison avant de déplacer une borne ou de poser un câble Ethernet.
Une réponse d’IA cite votre PDF : vérifiez le passage avant de le reprendre
Retrouver la bonne page, contrôler une citation et relire une cellule de tableau pour vérifier qu’un PDF étaye bien la réponse d’une IA.
S’abonner par RSS
Copiez l’adresse du flux dans votre lecteur RSS.
Ajoutez cette adresse à votre lecteur RSS pour recevoir les nouveaux articles.