Cuánta memoria necesita una IA local para trabajar con documentos largos
Los pesos del modelo no cubren toda la memoria necesaria. Cómo evaluar la caché KV, el contexto, la cuantización y el reparto entre CPU y GPU.
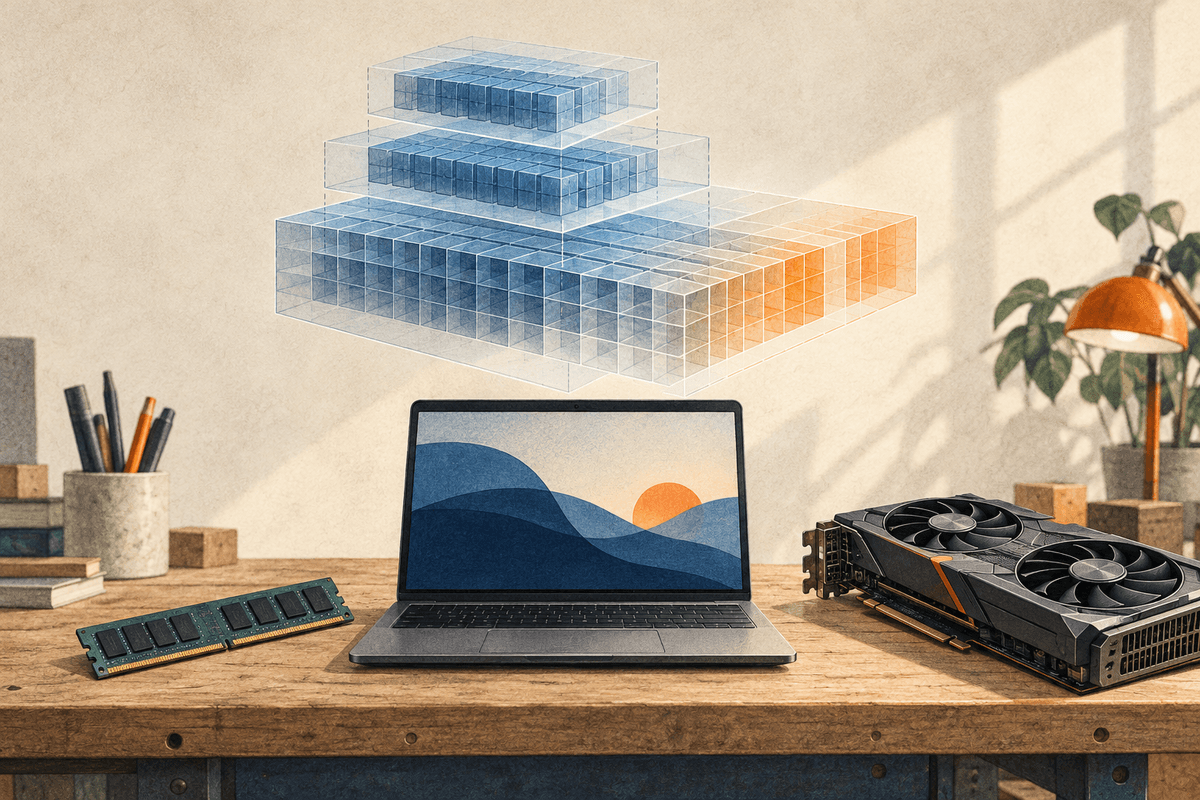
Quieres pedirle a un asistente local que revise un informe largo. El archivo del modelo parece caber en la memoria disponible, pero falta presupuestar el texto de trabajo. Durante la inferencia también se guardan estados de atención y se asigna memoria temporal; ampliar el contexto aumenta las necesidades.123
Evalúa la tarea completa: cargar el modelo, procesar el informe y terminar una respuesta útil. Este artículo explica cómo preparar esa evaluación a partir de documentación oficial. No contiene mediciones propias de equipos.
Un archivo pequeño deja varias partidas pendientes
Los pesos contienen los parámetros aprendidos. La cuantización reduce la precisión con la que se almacenan para ahorrar memoria, procurando conservar la exactitud. La documentación oficial en español también presenta la cuantización como una forma de reducir el consumo al ejecutar modelos de conversación.45
Como estimación de planificación, considera los pesos residentes, la caché KV, los espacios temporales de cálculo y las asignaciones del entorno de ejecución. Reserva aparte lo que necesitan las demás aplicaciones. La ubicación de cada componente depende del reparto entre dispositivos; además, la carga puede tener un pico distinto al de la generación.163
Para los pesos, multiplicar parámetros por bits de almacenamiento y dividir entre ocho estima bytes bajo una hipótesis ideal: todos usan la misma precisión y se empaquetan sin sobrecostes. Hay métodos que conservan módulos con otra precisión y guardan constantes de cuantización. El archivo concreto y los informes del programa permiten corregir esa aproximación.47
La conversación tiene su propia memoria
Un Transformer autorregresivo aprovecha el texto anterior para generar el siguiente token. La caché de claves y valores, o caché KV, conserva resultados de atención de los tokens ya procesados para reutilizarlos. Es un estado asociado a la petición, separado de los pesos aprendidos.1
El comportamiento depende de la implementación. Una caché dinámica crece durante la generación. Una estática reserva una capacidad máxima por adelantado. En las capas con atención por ventana deslizante o por bloques, el crecimiento tiene límites propios. Por eso conviene consultar la arquitectura antes de extrapolar el consumo de otro modelo.8
En una estimación convencional de atención completa intervienen los tokens retenidos, las secuencias simultáneas, las capas, las cabezas KV, sus dimensiones y la precisión de la caché. Una cifra de parámetros no especifica todo eso. Mantén modelo y precisión constantes para comparar el efecto de alargar el texto.18
Incluye instrucciones e historial al preparar la entrada y deja margen para la respuesta. El contexto disponible debe cubrir también la continuación. La guía española de conversación recuerda que el historial se actualiza al seguir hablando con el modelo.125
Fija el contexto antes de aumentar la concurrencia
Ollama explica que las peticiones paralelas de un modelo aumentan su asignación de contexto. Compartir pesos no elimina el estado de cada petición activa. Multiplicar el tamaño del archivo por el número de personas tampoco describe bien ese reparto.9
Para uso personal, empieza con peticiones secuenciales y un documento representativo. Si vas a compartir el servicio, prueba después la coincidencia de peticiones largas. Ollama distingue la cola de espera del procesamiento paralelo y ofrece controles diferentes para ambas cosas.9
Consulta el contexto asignado y la distribución CPU/GPU con ollama ps. Al comparar, establece explícitamente la longitud. La FAQ y la guía de contexto describen actualmente valores predeterminados diferentes; inspeccionar la configuración evita depender de esa discrepancia.92
Hay dos decisiones de cuantización
El nombre del archivo de pesos no determina el formato de la caché. llama.cpp permite configurar por separado los tipos de claves y valores; Ollama tiene sus propios controles de cuantización KV. Comprueba lo que admite el programa que realmente utilizas.910
El ahorro también exige comprobar las respuestas. Ollama advierte de que el efecto de cuantizar la caché depende del modelo y de la tarea. Prepara documentos con detalles que puedas verificar y compara la extracción o el formato exigido manteniendo iguales las instrucciones. Cambia una precisión cada vez para poder interpretar el resultado.9
Tampoco hay una mejora de velocidad garantizada. Transformers señala que cuantizar la caché puede empeorar la latencia en contextos cortos si ya hay memoria de GPU suficiente. Usa esa opción para resolver una limitación observada y vuelve a medir la tarea.8
Interpreta los indicadores antes de liberar memoria
En PyTorch con CUDA, memory_allocated() informa de la memoria ocupada por tensores; memory_reserved() recoge la gestionada por el asignador de caché. Hay contadores equivalentes de máximos. La memoria reservada sin uso puede aparecer ocupada en nvidia-smi.6
Ambas cifras se solapan: sumarlas exagera el presupuesto. empty_cache() libera bloques de caché sin utilizar, pero mantiene los tensores activos. Para llama.cpp, consulta sus propios informes; estas funciones pertenecen a PyTorch.610
Repartir entre CPU y GPU cambia la prueba
llama.cpp permite limitar las capas almacenadas en VRAM. La descarga de caché de Transformers mueve la mayor parte de las cachés de capas a la CPU y las recupera cuando hacen falta. Anota qué objeto has trasladado, porque los mecanismos son distintos.810
Presupuesta por separado la RAM del sistema y la VRAM dedicada. La documentación de Transformers reconoce una posible pérdida de rendimiento al trasladar cachés. La transferencia y la ejecución dependen de la configuración; aquí no se propone un porcentaje universal de ralentización.83
La tabla ayuda a localizar qué observar. Son hipótesis iniciales que necesitan contraste con registros y mediciones.
| Cuándo aparece el problema | Qué revisar | Comparación útil |
|---|---|---|
| Al cargar | Pesos, ubicación y pico de carga3 | Un archivo menor con el resto igual |
| Con documentos largos | Asignación de contexto y caché KV82 | Menor contexto con el mismo modelo |
| Con peticiones superpuestas | Asignación para trabajo paralelo9 | Ejecutar las mismas tareas en serie |
| Tras terminar, la GPU sigue ocupada | Tensores activos y reserva de PyTorch6 | Contrastar allocated y reserved |
| El reparto a CPU tarda demasiado | Transferencias y ejecución83 | Cambiar solo la distribución |
Conserva la versión del archivo y del programa, el contexto, la precisión KV, el reparto y la concurrencia activa. Observa carga, procesamiento de entrada y generación, pues utilizan asignaciones diferentes.13
Repite el mismo documento cuando actualices el entorno. Una configuración útil debe completar esa tarea con respuestas y esperas aceptables para tu trabajo. Ese resultado ofrece una base concreta para decidir si necesitas cambiar de modelo.
Fuentes
Footnotes
-
Hugging Face Transformers — Original inglés sobre atención y dimensiones de la caché KV: https://huggingface.co/docs/transformers/en/cache_explanation ↩ ↩2 ↩3 ↩4 ↩5 ↩6
-
Ollama — Longitud de contexto y comprobación del contexto asignado; original inglés: https://docs.ollama.com/context-length ↩ ↩2 ↩3 ↩4
-
Hugging Face Accelerate — Carga, distribución y memoria adicional; original inglés: https://huggingface.co/docs/accelerate/en/concept_guides/big_model_inference ↩ ↩2 ↩3 ↩4 ↩5 ↩6
-
Hugging Face Transformers — Original inglés sobre cuantización y exactitud: https://huggingface.co/docs/transformers/en/quantization/overview ↩ ↩2
-
Hugging Face en español — Conversaciones, historial y reducción de memoria mediante cuantización: https://huggingface.co/docs/transformers/es/conversations ↩ ↩2
-
PyTorch CUDA — Memoria asignada, reservada y liberación de caché; documentación en inglés: https://docs.pytorch.org/docs/2.14/notes/cuda.html ↩ ↩2 ↩3 ↩4
-
Hugging Face bitsandbytes — Constantes de cuantización y módulos con distintas precisiones; original inglés: https://huggingface.co/docs/transformers/en/quantization/bitsandbytes ↩
-
Hugging Face Transformers — Estrategias de caché, reservas y costes de traslado; documentación en inglés: https://huggingface.co/docs/transformers/en/kv_cache ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7
-
Ollama FAQ — Concurrencia, cola, distribución y cuantización de caché; original inglés: https://docs.ollama.com/faq ↩ ↩2 ↩3 ↩4 ↩5 ↩6
-
llama.cpp server — Opciones oficiales de capas GPU y tipos de caché: https://github.com/ggml-org/llama.cpp/blob/master/tools/server/README.md ↩ ↩2 ↩3
Una extensión pide acceso a todas las webs: decide qué permitir
Revisa el acceso a sitios, la navegación privada y la sincronización de extensiones en Chrome, Edge y Firefox.
Wifi de malla lenta con buena señal: revisa el enlace entre nodos
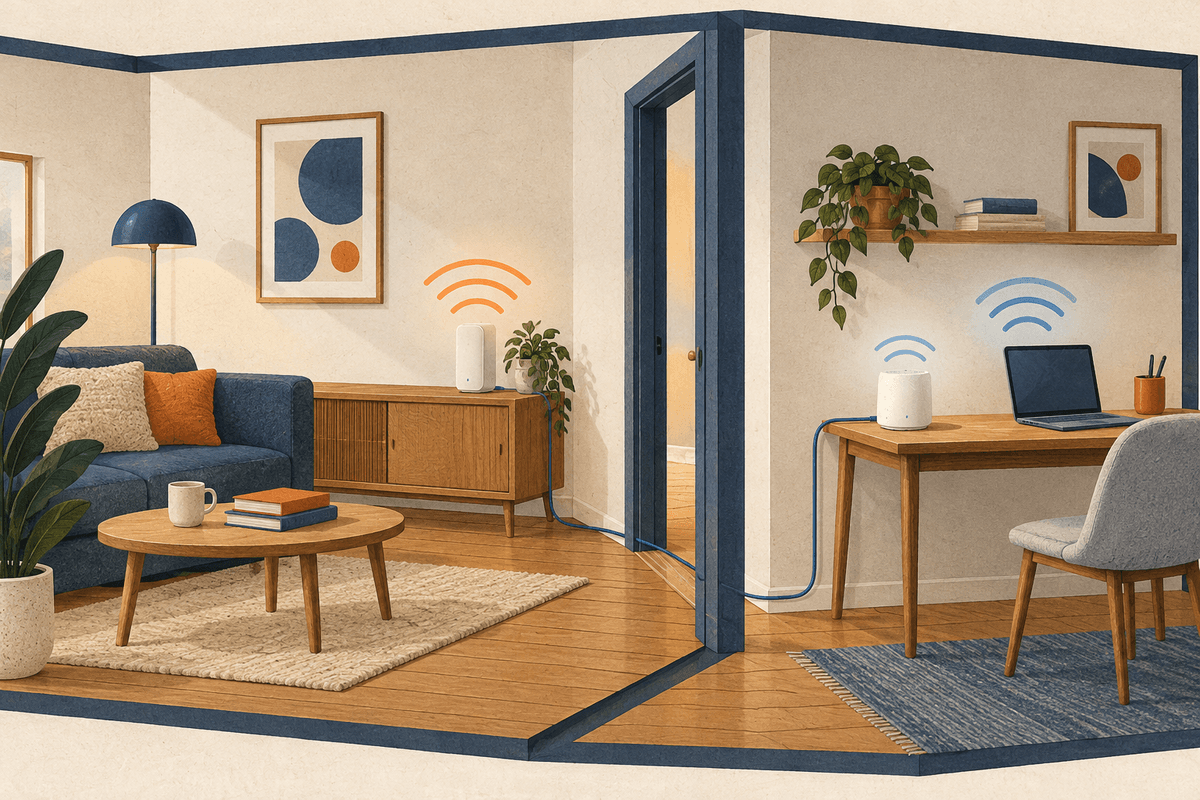
Localiza la lentitud con una prueba por cable en el router principal, comparaciones desde el mismo equipo y una revisión de los enlaces entre nodos.
La IA cita tu PDF: comprueba qué dice la página antes de usar la respuesta
Cómo contrastar una cita de IA con el PDF original, revisar el OCR, localizar la página correcta y verificar una cifra dentro de su tabla.
Suscríbete por RSS
Copia la dirección del canal y añádela a tu lector RSS.
Añade esta dirección a tu lector RSS para recibir nuevos artículos.