本地大模型的内存需求:权重之外还要计算什么
根据官方文档,解释权重、KV 缓存、上下文和并发怎样占用内存,以及量化和 CPU 分担会带来哪些取舍。
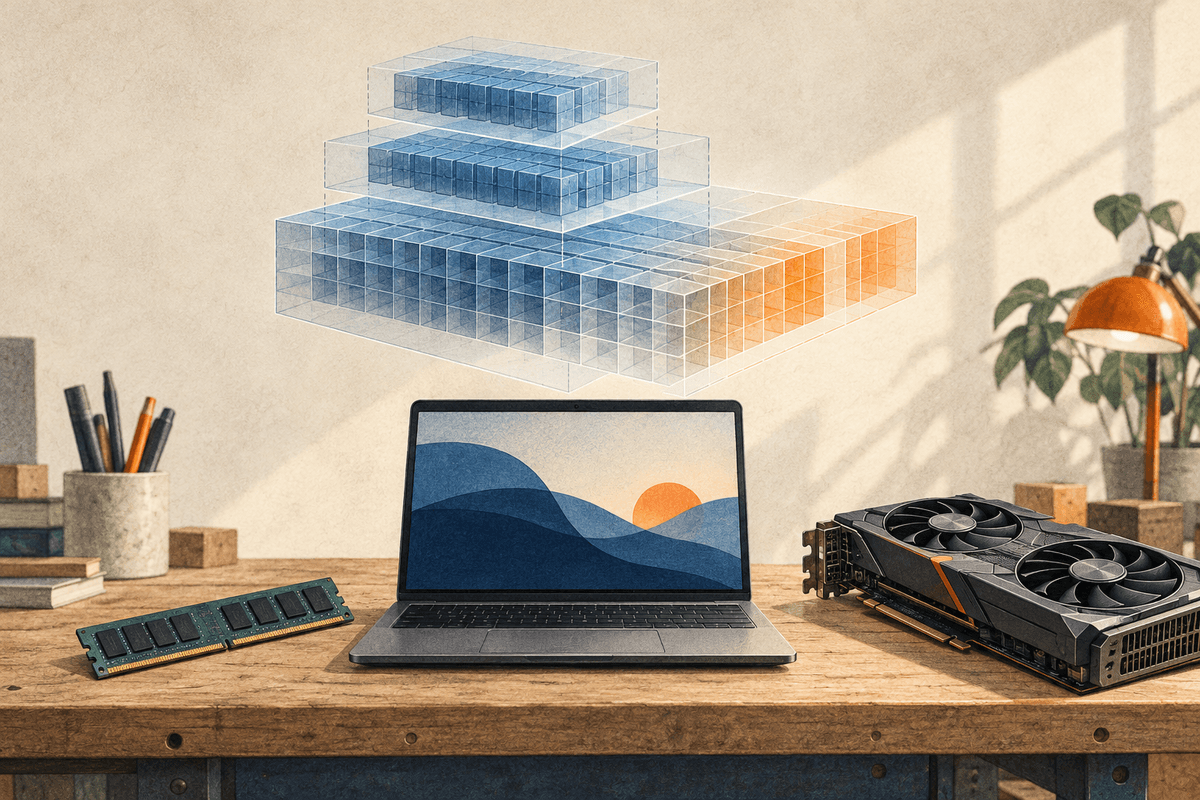
准备让本地助手分析一份长文档,你可能先比较模型文件大小和电脑的剩余内存。接着还得回答一个问题:文档和生成的回答放在哪里?推理时,模型需要保存注意力计算的中间结果,还需要运行空间。上下文越长,内存需求也会改变。123
因此,判断配置是否够用,要观察完整任务。下面根据官方文档解释各项开销,没有使用自测硬件数据,也不提供根据参数量挑选电脑的排名。
权重只是预算里的一项
权重保存训练得到的参数。量化用较低精度保存权重,减少内存占用,同时尽量保留准确性。同一个模型的不同量化文件,占用空间可能不同,回答质量也需要重新评估。45
可以先用这个估算关系整理预算:所需内存约等于常驻权重、KV 缓存、临时计算空间和运行时分配的空间之和。其他应用另行计算。这只是帮助理解的估算,各部分放在 CPU 内存还是 GPU 显存,要根据运行方式确认;加载过程也可能出现额外峰值。163
如果假设所有参数都使用相同位宽并且紧密存储,“参数量 × 每个参数的位数 ÷ 八”可以估算权重字节数。实际量化方法还可能保存量化常数,部分模块继续使用其他精度,所以需要结合文件和运行日志修正。这个公式没有包括缓存。47
长对话需要保存自己的状态
自回归 Transformer 根据前面的内容逐个生成词元。KV 缓存保存已经处理过的词元对应的注意力键和值,让后续计算直接复用。它随请求产生,与训练得到的权重分开占用空间。1
缓存怎样占用内存,还要查看实现。动态缓存会随着生成增加;静态缓存提前预留最大容量,短对话也可能对应较大的预留空间。使用滑动窗口或分块注意力的层,缓存增长有相应边界,不能把一种架构的估算直接套用到其他模型。8
估算常规全注意力缓存,需要考虑保留的词元数量、同时处理的序列、缓存层数、KV 头数、每个头的维度和缓存精度。参数量没有完整说明这些条件。比较上下文长短带来的变化时,应当固定模型和缓存精度。18
准备测试输入时,也要给回答留出空间。系统提示、历史对话和文档一起构成实际输入;只计算粘贴的正文,容易低估上下文。可以使用模型对应的分词器确认实际长度,再设置符合任务的生成上限。12
上下文和并发要一起设置
Ollama 文档说明,扩大上下文会增加内存需求;同一个模型同时处理更多请求,也会扩大上下文分配。加载的权重可以供请求共用,每个正在处理的请求仍然需要相应状态,不能把模型文件大小简单乘以用户人数。92
如果只是整理会议记录,先挑选一份确实需要处理的记录,把平时使用的提示词一起保存。核对目标可以具体到日期、负责人和待办事项;这些是建议采用的检查内容,没有预设模型能够全部答对。
个人使用可以先让请求依次执行,确认长文档能够完成。准备给多人使用时,再重现长请求重叠的情况。等待队列和正在执行的请求要分开观察,Ollama 对并行处理和排队分别提供设置。9
运行 ollama ps,检查已分配的上下文,以及 CPU、GPU 的分配情况。对比配置时明确设置上下文长度:目前 FAQ 和上下文指南对默认长度的描述并不一致,直接检查实际配置更容易复现。92
压缩权重后,还要单独考虑缓存
权重量化文件的名称,不能说明 KV 缓存采用什么精度。llama.cpp 为键缓存和值缓存提供单独设置,Ollama 也有缓存量化选项。首先确认当前后端支持哪些配置,再决定是否修改。910
量化节省多少空间,与回答能否接受,需要分别判断。Ollama 提醒,缓存量化对质量的影响取决于模型和任务;Transformers 文档还提醒,短上下文且显存充足时,缓存量化可能增加延迟。低精度并不自动带来更好的使用体验。89
建议保留几份可以人工核对答案的任务,例如从文档提取指定细节、按照固定格式输出。固定模型和提示格式,每次只修改一种精度设置。比较遗漏、格式错误和内存占用,再决定节省的空间是否值得。这里给出的是评估办法,没有预设通过率。
监控里显示的占用,需要分清来源
PyTorch 的 CUDA 分配器会保留空间供后续复用。memory_allocated() 观察张量占用,memory_reserved() 观察分配器管理的总量,两者还有对应的峰值统计。分配器保留但暂时未使用的空间,也可能在 nvidia-smi 里显示为已占用。6
这两项存在包含关系,不能直接相加。empty_cache() 可以释放未使用的缓存块,正在使用的权重和 KV 张量仍然占用内存。反复清理缓存,无法替代减少活跃数据。上述接口属于 PyTorch,使用 llama.cpp 时要查看它自己的报告。610
CPU 分担以后,任务仍要完成一次
llama.cpp 支持 CPU 和 GPU 混合推理,GPU 层数设置控制最多多少层放入显存。Transformers 的缓存卸载则把多数层的 KV 缓存放到 CPU,计算时再调入。这两种方式移动的内容不同,记录测试配置时要写清楚。81011
独立显卡的显存与系统内存需要分别预算。缓存卸载可能降低生成吞吐,代价取决于模型、上下文和生成方式,官方说明没有给出适用于所有电脑的固定降速比例。应当用自己的长任务确认等待时间。83
记录结果时,也把“是否完成”和“是否愿意每天使用”分开判断。假如减少上下文以后遗漏了任务必需的原文,就需要重新选择任务范围或模型。先写清楚必须保留的材料,再比较配置,避免为了通过容量检查而改变原本的工作要求。
遇到内存不足,可以先按发生阶段缩小范围。下表列出排查方向,具体原因仍然需要日志和对比确认。
| 出现的情况 | 优先检查 | 可以怎样比较 |
|---|---|---|
| 加载阶段失败 | 权重、放置方式、加载峰值3 | 换用较小文件,保持其他条件一致 |
| 输入长文档后失败 | 上下文分配和 KV 缓存82 | 相同模型缩短上下文 |
| 请求重叠时失败 | 并行请求的分配9 | 改为依次执行同一组任务 |
| 请求结束后显存仍高 | PyTorch 活跃张量和预留空间6 | 同时观察 allocated 与 reserved |
| 分担到 CPU 后等待过长 | 传输与执行开销83 | 用同一任务比较不同分配方式 |
保存模型文件版本、运行时版本和上下文设置,也记录缓存精度、分配方式及活跃请求数。容量验证应当覆盖加载、处理输入和生成回答,空闲时的截图无法代替这些阶段的观察。13
下次升级模型或运行时,就重新执行这份长任务。最终保留的配置,应当能够完成文档处理,回答质量和等待时间也符合你的要求。
参考来源
Footnotes
-
Hugging Face Transformers — 英文原始文档,解释 KV 缓存与张量维度:https://huggingface.co/docs/transformers/en/cache_explanation ↩ ↩2 ↩3 ↩4 ↩5 ↩6
-
Ollama 上下文指南 — 英文官方说明,上下文长度与实际配置检查:https://docs.ollama.com/context-length ↩ ↩2 ↩3 ↩4 ↩5
-
Hugging Face Accelerate — 英文官方说明,加载峰值、设备分配与额外运行空间:https://huggingface.co/docs/accelerate/en/concept_guides/big_model_inference ↩ ↩2 ↩3 ↩4 ↩5 ↩6
-
Hugging Face Transformers — 当前英文量化总览,说明低精度存储与准确性的取舍:https://huggingface.co/docs/transformers/en/quantization/overview ↩ ↩2
-
Hugging Face 中文量化文档 — v4.42.0 版本,用于中文术语和模块精度概念核对,不作为当前参数兼容性的依据:https://huggingface.co/docs/transformers/v4.42.0/zh/main_classes/quantization ↩
-
PyTorch CUDA 文档 — 英文官方说明,活跃张量、预留内存与缓存释放:https://docs.pytorch.org/docs/2.14/notes/cuda.html ↩ ↩2 ↩3 ↩4
-
Hugging Face bitsandbytes 文档 — 当前英文说明,量化常数与不同模块的精度;并参照旧版官方中文文档核对术语:https://huggingface.co/docs/transformers/en/quantization/bitsandbytes ↩
-
Hugging Face Transformers — 英文缓存策略,说明动态、静态、量化与卸载的边界:https://huggingface.co/docs/transformers/en/kv_cache ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7
-
Ollama FAQ — 英文官方说明,并发、排队、内存分配及缓存量化:https://docs.ollama.com/faq ↩ ↩2 ↩3 ↩4 ↩5 ↩6
-
llama.cpp 服务端文档 — 官方参数说明,GPU 层数和键值缓存类型:https://github.com/ggml-org/llama.cpp/blob/master/tools/server/README.md ↩ ↩2 ↩3
-
llama.cpp — 项目官方介绍,说明 CPU 与 GPU 混合推理:https://github.com/ggml-org/llama.cpp/blob/master/README.md ↩
通过 RSS 订阅新文章
复制下方地址,添加到常用的 RSS 阅读器。
将上方地址添加到 RSS 阅读器,即可获取新文章。