AI อ้าง PDF ของคุณ ตรวจอย่างไรว่าต้นฉบับรองรับคำตอบจริง
วิธีเทียบคำตอบ AI กับ PDF ต้นฉบับ ตั้งแต่เลขหน้าและข้อความจาก OCR ไปจนถึงคำอ้างและตัวเลขในตาราง พร้อมวิธีรับมือเมื่อแหล่งอ้างอิงไม่ตรง
คุณกำลังเตรียมบันทึกส่งต่อให้ทีม มีตัวเลขจากรายงาน PDF อยู่ในคำตอบของ AI และมีลิงก์อ้างอิงกำกับ ก่อนนำประโยคนั้นไปใช้ ลองเปิดตารางในรายงานแล้วตามหาตัวเลขด้วยตัวเอง สถานการณ์สมมตินี้ช่วยกำหนดงานให้ชัดว่า ต้องตรวจทั้งตำแหน่งข้อมูลและความหมายของประโยคที่กำลังจะส่งต่อ
เปิดคำตอบไว้ข้าง PDF แล้วเลือกตรวจทีละประโยคที่ต้องการใช้ เอกสารของ Google เกี่ยวกับการตรวจว่าคำตอบมีหลักฐานรองรับกำหนดให้ข้อมูลต้นทางรองรับข้อกล่าวอ้างครบทั้งประโยค การรองรับเพียงบางส่วนยังไม่ผ่านเกณฑ์นี้1 ใช้เกณฑ์นี้อ่านต้นฉบับได้ โดยไม่ต้องอาศัยคำยืนยันจากผู้ช่วยเพียงอย่างเดียว
เริ่มตรวจตัวเลขจากตารางเต็ม
ถ้าคำตอบอ้างตัวเลขในตาราง ให้เปิดตารางเต็มก่อน ตามหาแถวที่กล่าวถึง แล้วไล่ไปยังคอลัมน์ที่เกี่ยวข้อง จดค่าพร้อมหน่วย รวมถึงคำขยายในหัวตารางและหมายเหตุที่ผูกกับช่องนั้น
ลองพักคำตอบของ AI ไว้ก่อน จดข้อมูลจากต้นฉบับแล้วค่อยนำมาเทียบ วิธีนี้เป็นข้อเสนอเพื่อให้เห็นขั้นตอนการตรวจชัดเจน ไม่มีการอ้างผลวัดความแม่นยำ หากตารางต่อไปอีกหน้า ให้เปิดทั้งสองส่วนและตรวจว่าหัวคอลัมน์ใดยังใช้กับข้อมูลในหน้าต่อ
คำว่า “ค่าสูงสุด” ในคำตอบควรตรงกับหัวตาราง หากต้นฉบับระบุ “ค่าทั่วไป” ให้แก้ถ้อยคำก่อนนำไปใช้ เมื่อคำตอบมีการคำนวณ ให้คำนวณซ้ำด้วยตัวเองเพื่อตรวจผลลัพธ์ เก็บค่าตั้งต้นและวิธีคำนวณแยกจากค่าที่คัดมาจากตาราง เพื่อให้คนอ่านทำซ้ำได้
กลับไปหาไฟล์ฉบับที่ AI ได้รับ
บันทึกคำตอบเดิมและระบุไฟล์ที่แนบในการสนทนา จดชื่อเอกสารกับวันที่แก้ไขถ้ามี หากแนบหลายฉบับ ต้องรู้ก่อนว่าลิงก์อ้างอิงชี้ไปที่ไฟล์ไหน
เว็บไซต์ของเจ้าของเอกสารอาจมีฉบับใหม่ให้ตรวจเพิ่มเติม แต่ระหว่างตรวจคำตอบเดิมควรเก็บไฟล์เดิมไว้ การเปลี่ยนฉบับกลางทางทำให้ระบุได้ยากว่าข้อความต่างกันเพราะเอกสารถูกแก้หรือเพราะคำตอบอ่านคลาดเคลื่อน
เมื่อพบว่าลิงก์เปิดคนละฉบับ ให้จดความต่างไว้และพักการใช้ประโยคนั้นก่อน ยังไม่ควรแก้ข้อความให้ตรงกับไฟล์ใหม่โดยไม่บอกว่าเปลี่ยนแหล่งอ้างอิง
ระบุเลขหน้าให้คนอื่นเปิดตามได้
Adobe อธิบายว่าเลขที่ใช้ในแถบนำทางอาจต่างจากเลขที่พิมพ์อยู่บนหน้าเอกสาร2 ในบันทึกการตรวจ ให้เขียนทั้งลำดับหน้าในไฟล์และเลขบนหน้ากระดาษ พร้อมชื่อหัวข้อที่ช่วยยืนยันตำแหน่ง
อย่าสมมติว่าทุกหน้าคลาดกันเท่ากับจำนวนหน้าปก ลองตรวจหน้าที่ถูกอ้างจริง โดยเฉพาะเมื่อเปลี่ยนบทหรือเข้าสู่ภาคผนวก เป้าหมายคือให้คนอีกคนเปิดมาที่ข้อความเดียวกันได้
หากอ่านข้อมูลอ้างอิงจาก API ต้องดูคำอธิบายช่วงหน้าของระบบนั้นด้วย ช่วงหน้าอ้างอิง PDF ของ Anthropic เริ่มนับจากหนึ่งและไม่รวมหน้าปลายช่วง3 กติกานี้เป็นของอินเทอร์เฟซดังกล่าว ไม่ควรนำไปตีความข้อมูลจากทุกผลิตภัณฑ์
เทียบข้อความที่คัดลอกกับภาพต้นฉบับ
เลือกประโยคสั้นจากหน้าที่อ้างแล้ววางในโปรแกรมแก้ไขข้อความธรรมดา เทียบสิ่งที่ได้กับหน้าที่เห็น การลองเช่นนี้ตรวจสำเนา PDF ในมือคุณ แต่ยังไม่ได้แสดงว่าแอปออนไลน์รับข้อมูลใดเข้าไปจริง
OCR ของ Acrobat สร้างชั้นข้อความที่ค้นหาได้ และ Adobe แนะนำให้ตรวจผลการรู้จำหลังประมวลผล4 ขยายหน้าต้นฉบับเมื่อข้อสรุปขึ้นอยู่กับคำปฏิเสธ จุดทศนิยม หรือเครื่องหมายอ้างถึงหมายเหตุ
ถ้าค้นหาทั้งประโยคไม่พบ ลองใช้วลีสั้นที่จำแนกได้ชัด แล้วอ่านหน้าที่ถูกอ้างด้วยตา หากยังหาไม่เจอให้ระบุว่ายังตรวจไม่ได้ การให้ AI เติมคำที่อ่านไม่ออกไม่ใช่เหตุผลเพียงพอที่จะนำคำนั้นมาใช้แทนต้นฉบับ
อ่านให้พ้นส่วนข้อความที่ระบบดึงมา
เอกสารของ Google แยกการดึงข้อความดิจิทัล การอ่านโครงหน้า และการแบ่งเอกสารเป็นส่วนย่อยสำหรับค้นคืน5 รหัสอ้างอิงช่วยระบุส่วนที่ค้นพบ ส่วนเนื้อหานั้นรองรับข้อสรุปหรือไม่ต้องตรวจแยกกัน51 ให้กลับไปอ่านย่อหน้าเต็ม รวมถึงประโยคก่อนหน้าและถัดไป
ถ้าแอปแสดงข้อความอ้างอิงได้ ให้ขอข้อความและตำแหน่งแล้วตรวจใน PDF อีกครั้ง คำตอบที่เชื่อมข้อมูลหลายหัวข้อควรตรวจทีละส่วน หากความเชื่อมโยงมาจากการตีความของคุณ ให้เขียนให้เห็นว่าเป็นข้อสรุปของผู้ตรวจ
ตารางนี้เสนอจุดที่ควรตรวจต่อเมื่อพบความไม่ตรงกัน อ้างอิงกลไกในเอกสาร ไม่ได้เปรียบเทียบอัตราความผิดพลาด4235
| สิ่งที่พบ | ตรวจตรงไหนต่อ | สิ่งที่ต้องการยืนยัน |
|---|---|---|
| ลิงก์เปิดหน้าที่คล้ายแต่ไม่ตรง | ลำดับในไฟล์ เลขพิมพ์ และหัวข้อ | ต่างกันเพราะวิธีนับหน้าหรือไม่ |
| ข้อความที่คัดลอกต่างจากภาพ | ภาพสแกนที่ขยายแล้ว | ใช้ข้อความส่วนนี้ตรวจคำตอบได้หรือไม่ |
| ส่วนที่อ้างไม่มีเงื่อนไข | ย่อหน้าเต็มและหมายเหตุ | คำตอบขยายขอบเขตเกินต้นฉบับหรือไม่ |
| ตัวเลขไม่มีหัวตาราง | แถว คอลัมน์ หน่วย และหมายเหตุ | ตัวเลขบอกค่าอะไร |
| อ้างเพียงชื่อไฟล์หรือส่วนย่อย | ประโยคที่รองรับในต้นฉบับ | คนอื่นตามหาหลักฐานเดียวกันได้หรือไม่ |
ตรวจคำอ้างโดยรักษาเงื่อนไขเดิม
ใช้ประโยคสมมติเพื่ออธิบาย เช่น คู่มือเขียนว่า “สำหรับใช้ภายในอาคารเท่านั้น” หากคำตอบอาศัยประโยคนี้อนุญาตให้ใช้กลางแจ้ง ข้อสรุปย่อมขัดกับข้อความ ต้องแก้ข้อสรุปก่อนส่งต่อ
สำหรับคำอ้างจริง ให้ค้นวลีที่มีลักษณะเฉพาะแล้วเทียบทั้งประโยค อ่านบริบทว่ากล่าวถึงรุ่นใดและมีเงื่อนไขอะไร คำที่ตัดออกต้องไม่ทำให้ความหมายเปลี่ยน หากแปลคำอ้าง ให้ระบุว่าเป็นคำแปลและเก็บต้นฉบับไว้ในบันทึก
ฟีเจอร์อ้างอิง PDF ของ Anthropic ต้องมีข้อความที่ดึงออกมาได้ และยังไม่รองรับการอ้างอิงภาพ3 สำหรับไฟล์สแกนจึงควรตรวจว่าแอปใช้วิธีอ่านและอ้างอิงแบบใด ข้อจำกัดนี้ไม่ควรถูกสรุปเหมารวมไปยังทุกระบบ
Google มีเอกสารภาษาไทยอธิบายว่า Gemini API อ่านทั้งข้อความและองค์ประกอบภาพใน PDF รวมถึงตารางกับกราฟได้6 ถ้าหลักฐานอยู่ในรูป ให้ตรวจป้ายกำกับและคำอธิบายจากรูปต้นฉบับด้วย ตรวจด้วยว่าแอปที่ใช้อยู่ส่งข้อมูลเหล่านี้ให้โมเดลหรือไม่ และเทียบช่องข้อมูลต้นฉบับก่อนใช้ตัวเลข
พักประโยคที่ยังตรวจไม่ผ่าน
หากหาคำอ้างไม่พบ ระบุช่องตัวเลขไม่ได้ หรือพบว่าเป็นคนละฉบับ ให้นำประโยคนั้นออกจากบันทึกชั่วคราว เก็บตำแหน่งและรายละเอียดที่ไม่ตรงกันไว้ เพื่อให้ผู้ตรวจคนถัดไปทำงานต่อได้
คำขอตรวจซ้ำควรเจาะจงให้ AI แสดงข้อความรองรับ ตำแหน่ง และเงื่อนไขที่ใช้ได้ คำตอบใหม่ยังต้องเทียบกับ PDF หากยังไม่มีหลักฐานรองรับ ให้ลดขอบเขตคำกล่าวหรือเอาออก
เก็บข้อความสุดท้าย ย่อหน้าหรือตารางที่ใช้ และตำแหน่งหน้าทั้งสองแบบ แยกผลว่าได้รับการรองรับครบ รองรับบางส่วน ขัดกับต้นฉบับ หรือยังอ่านไม่ได้ บันทึกนี้แสดงขอบเขตที่คุณตรวจแล้ว ส่วนความถูกต้องและความเป็นปัจจุบันของเอกสารเองต้องพิจารณาแยกต่างหาก
แหล่งอ้างอิง
Footnotes
-
Google Cloud — เงื่อนไขการรองรับคำกล่าวทั้งประโยค เอกสารภาษาอังกฤษ: https://docs.cloud.google.com/generative-ai-app-builder/docs/check-grounding ↩ ↩2
-
Adobe Acrobat — เลขนำทางและเลขที่พิมพ์บนหน้า เอกสารภาษาอังกฤษ: https://helpx.adobe.com/acrobat/desktop/edit-documents/organize-pages/renumber-pages.html ↩ ↩2
-
Anthropic — ตำแหน่งอ้างอิง PDF และข้อจำกัดภาพ เอกสารภาษาอังกฤษ: https://platform.claude.com/docs/en/build-with-claude/citations ↩ ↩2 ↩3
-
Adobe Acrobat — ชั้นข้อความ OCR และการตรวจผล เอกสารต้นทางภาษาอังกฤษ: https://helpx.adobe.com/acrobat/desktop/create-documents/scan-documents-to-pdfs/recognize-text.html ↩ ↩2
-
Google Cloud — การดึงข้อความ โครงหน้า และส่วนย่อย เอกสารภาษาอังกฤษ: https://docs.cloud.google.com/generative-ai-app-builder/docs/parse-chunk-documents ↩ ↩2 ↩3
-
Google AI สำหรับนักพัฒนา — การประมวลผล PDF ด้วย Gemini API เอกสารภาษาไทย: https://ai.google.dev/gemini-api/docs/document-processing?hl=th ↩
ส่วนขยายขออ่านทุกเว็บไซต์ ควรให้สิทธิ์แค่ไหน
ตรวจสิทธิ์เข้าถึงเว็บไซต์ของส่วนขยายใน Chrome, Edge และ Firefox รวมถึงผู้พัฒนา การใช้งานในโหมดส่วนตัว และการซิงค์ส่วนขยาย
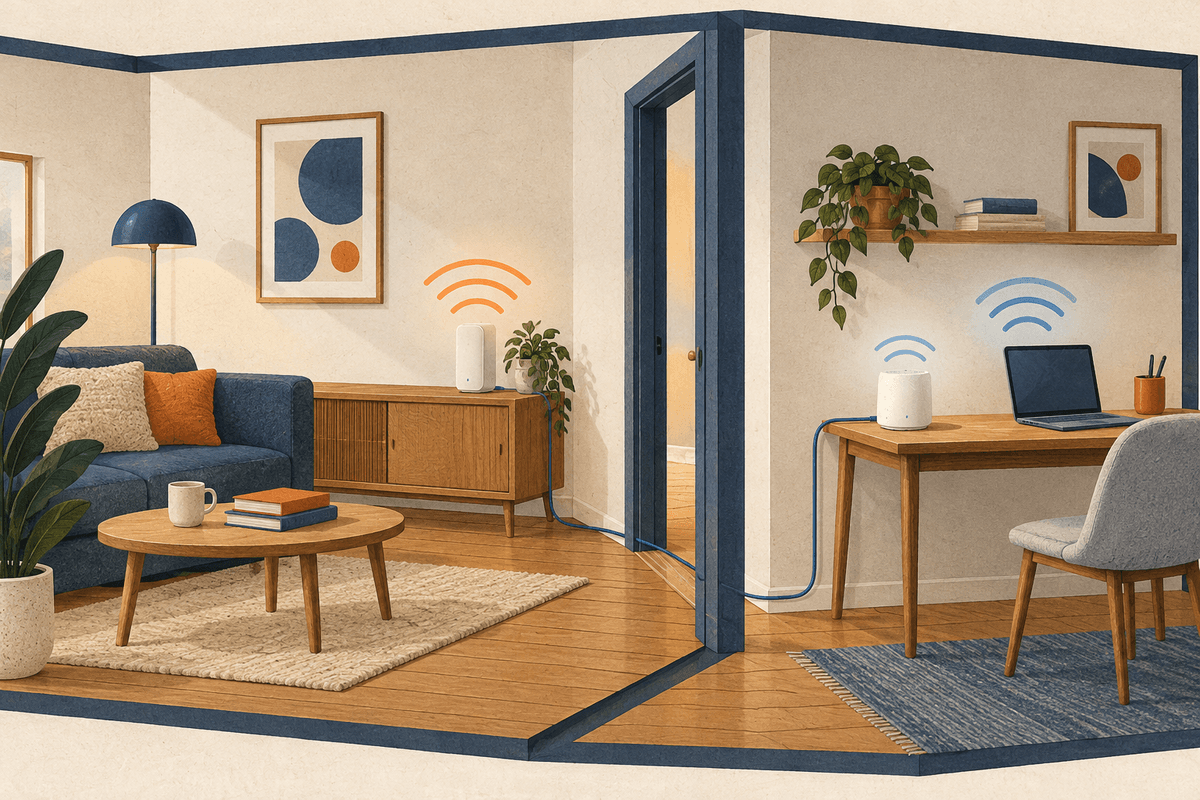
ไวไฟเมชสัญญาณเต็มแต่ยังช้า ลองตรวจทางเชื่อมระหว่างจุดกระจายสัญญาณ
เปรียบเทียบความเร็วผ่านสายและไวไฟด้วยเครื่องเดียวกัน แล้วตรวจการเชื่อมต่อกับตำแหน่งวางจุดกระจายสัญญาณ
รันโมเดลภาษาในเครื่อง ต้องเผื่อหน่วยความจำให้บทสนทนาด้วย
ประเมินหน่วยความจำจากน้ำหนักโมเดล แคช KV และความยาวบริบท พร้อมตรวจผลของการควอนไทซ์และการแบ่งงานระหว่างซีพียูกับจีพียู
ติดตามบทความภาษาไทย
คัดลอกที่อยู่ด้านล่างไปเพิ่มในแอปอ่าน RSS ที่ใช้
ฟีดนี้มีเฉพาะบทความภาษาไทย