PHP 披露争议:公开漏洞的人应该承担哪些责任
PHP、Node.js、Go、Java 的安全消息集中出现。围绕 PHP 的披露争议,讨论研究者、补丁分发者和维护团队怎样承担公开决定的后果。
按模型、公司或技术问题,查找 Roundup Tech 的文章。
32 篇文章
PHP、Node.js、Go、Java 的安全消息集中出现。围绕 PHP 的披露争议,讨论研究者、补丁分发者和维护团队怎样承担公开决定的后果。
扩展申请读取所有网站时,先核对功能需要哪些页面。介绍 Chrome、Edge 和 Firefox 的网站授权、临时访问及无痕权限。
从主路由有线测速开始,分别检查终端连接、节点回程和摆放位置。准备使用网线连接节点时,也要核对型号、网口和工作模式。
回到 PDF 原页,核对 AI 引用的句子、页码和表格。扫描识别、文件版本和适用条件,都可能影响回答是否准确。
根据官方文档,解释权重、KV 缓存、上下文和并发怎样占用内存,以及量化和 CPU 分担会带来哪些取舍。
发出共享链接前,检查访问范围、编辑权限和文件夹继承。取消分享以后,也要确认其他入口是否仍然有效。
先检查电脑接口、线材和显示器输入,再排查扩展坞。充电功率不能直接说明一根线支持什么视频功能。
云同步会传播删除,设备备份也有自己的范围。先检查原件是否完整,再用测试文件演练恢复,弄清自己的备份能解决什么问题。
通行密钥由哪台设备或哪个密码管理器保存?旧手机清空之后怎样登录?从同步、备用登录和账号恢复三个环节检查。
分析 Mercury 3 的并行生成、GPU 利用率和分块输出,区分厂商公布的吞吐量与完成整项任务所需的时间。
整理 Claude Opus 5.5 与 GPT-6 Sol、Luna 的发布时间和 API 定价,比较推理 token 用量与评测口径对实际费用的影响。
Grok Build 与 ZCode 因上传用户代码和工作区数据受到质疑。分析两家的开源回应,以及公开代码能否解释此前的数据处理行为。
对照 DeepSeek V4.1-Flash、GLM-5.3-Flash 和 Gemini Flash 的公开规格,分析参数规模、默认推理设置与费用,说明名称能够传达的信息有限。
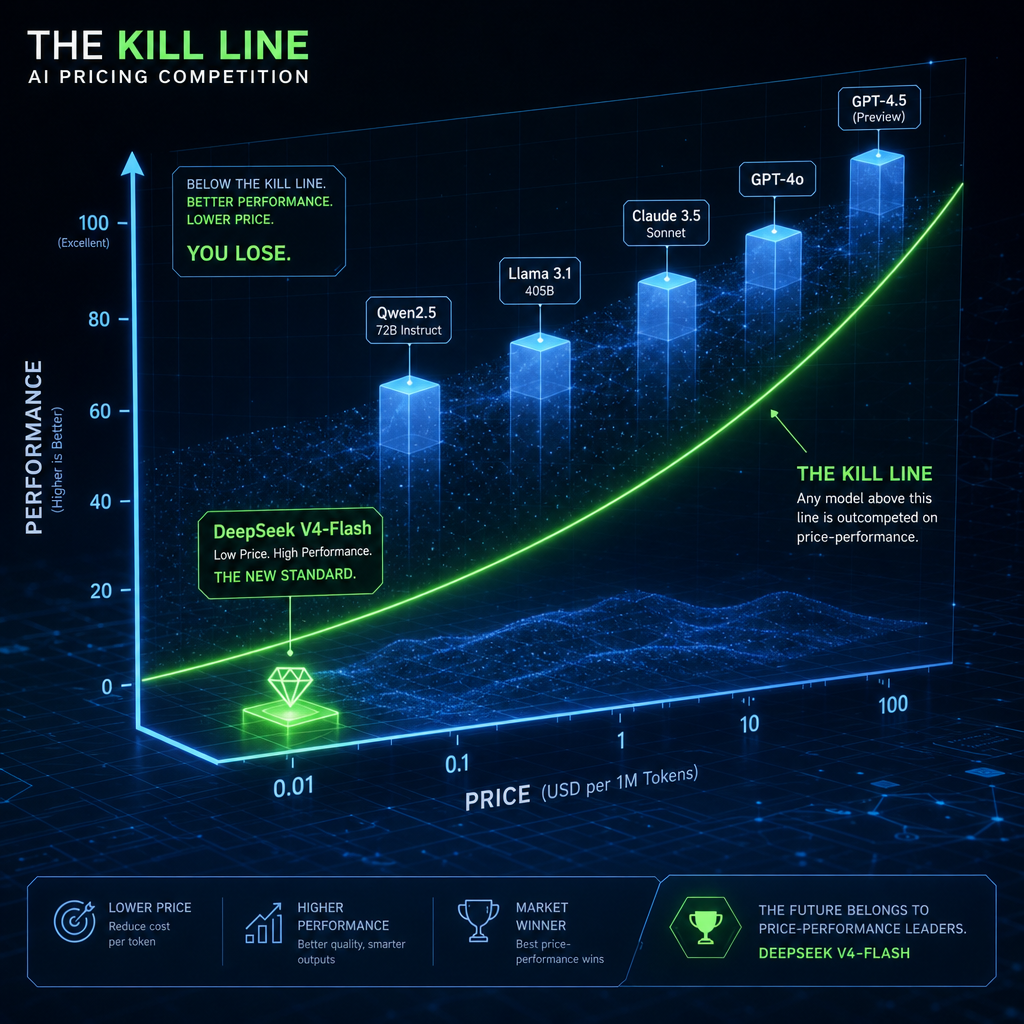
DeepSeek V4-Flash 在公开评测中显示出较低测试成本。结合 API 定价和任务质量,讨论评测开销与实际使用费用之间的区别。
一篇关于 AI 使用成本的随笔:费用怎样影响阅读文档、处理代码和安排长任务,以及预算之外的模型访问限制。
GPT-5.6 的开放范围受到限制,GLM-5.2 则以 MIT 许可发布。比较访问资格、模型下载和部署条件对使用者的影响。
机器人从视频学习动作,研究模型提出实验假设。结合化学和材料研究案例,讨论 AI 能够完成哪些工作,哪些仍然需要实验验证。
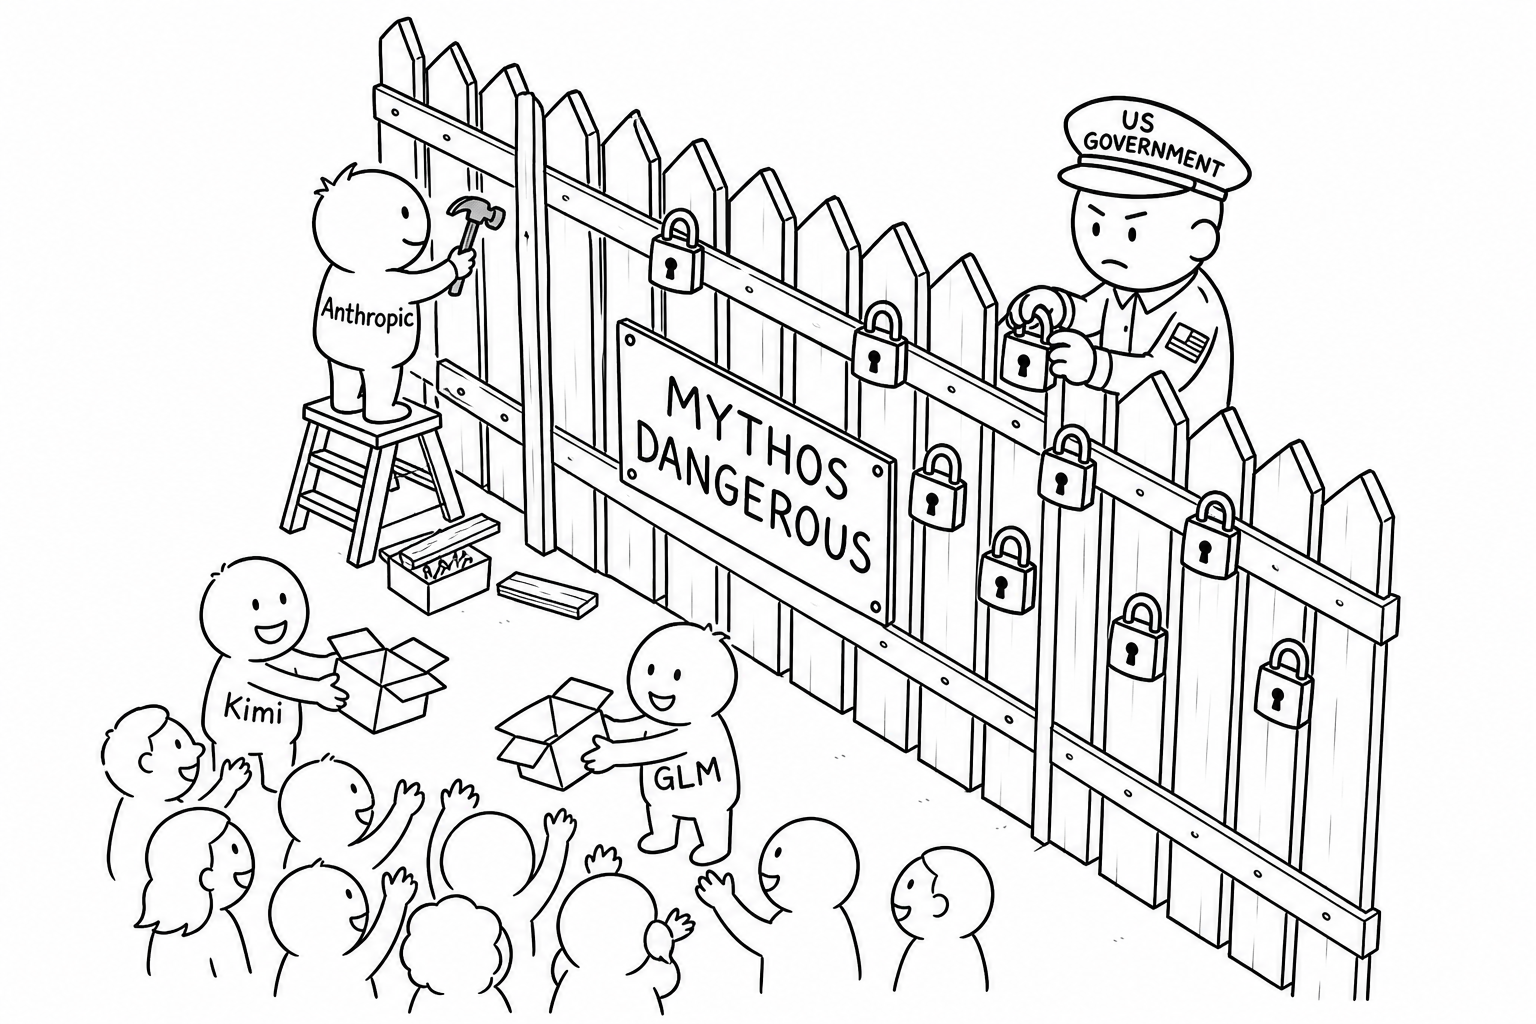
梳理 Fable 5、Mythos 的访问限制,以及 Kimi K2.7、GLM-5.2 的发布,比较授权、下载和实际使用上的差异。
根据 Anthropic 的递归自我改进报告,讨论内部自动化进展、结果评估和决策责任,以及跨机构协调面临的困难。
DeepSeek 将 V4-Pro 的促销价格改为长期定价。对照官方 API 与第三方托管服务的成本,分析降价怎样影响服务商的报价和收入。
OpenAI 报告模型找到了 Erdős 单位距离猜想的反例。结合数学家的评议和计算机辅助证明的历史,讨论发现、证明与独立核查的区别。
对照 Gemini Flash 的历代定价和 I/O 2026 公布的功能,讨论多模态能力、推理费用及开源替代方案的使用成本。
从金融分析工具和各行业的招聘变化,讨论 AI 对初级白领任务的影响,以及文凭和实际工作能力之间的关系。
OpenAI 与微软调整云服务和授权安排,Anthropic 获得 SpaceX 算力。结合协议内容,分析这些合作怎样影响模型公司的算力供应。
对照 Grok 4.3、DeepSeek V4 Flash、MiniMax M2.7 和 MiMo 2.5 的公开资料,比较模型规格、评测结果和 API 费用,说明评测口径的差别。
Warp 以 AGPL 许可开放终端代码,OpenAI 成为创始赞助方。结合公开说明,分析社区贡献、代理开发流程和商业收入之间的关系。
结合小米公布的编译器、视频编辑器和芯片设计任务,分析 MiMo V2.5 Pro 在长任务中的工具调用、上下文管理和可靠性。
DeepSeek V4 的开源发布与昇腾适配,为部署提供了不同选择。分析芯片支持、工具兼容和 API 费用对开发者的影响。
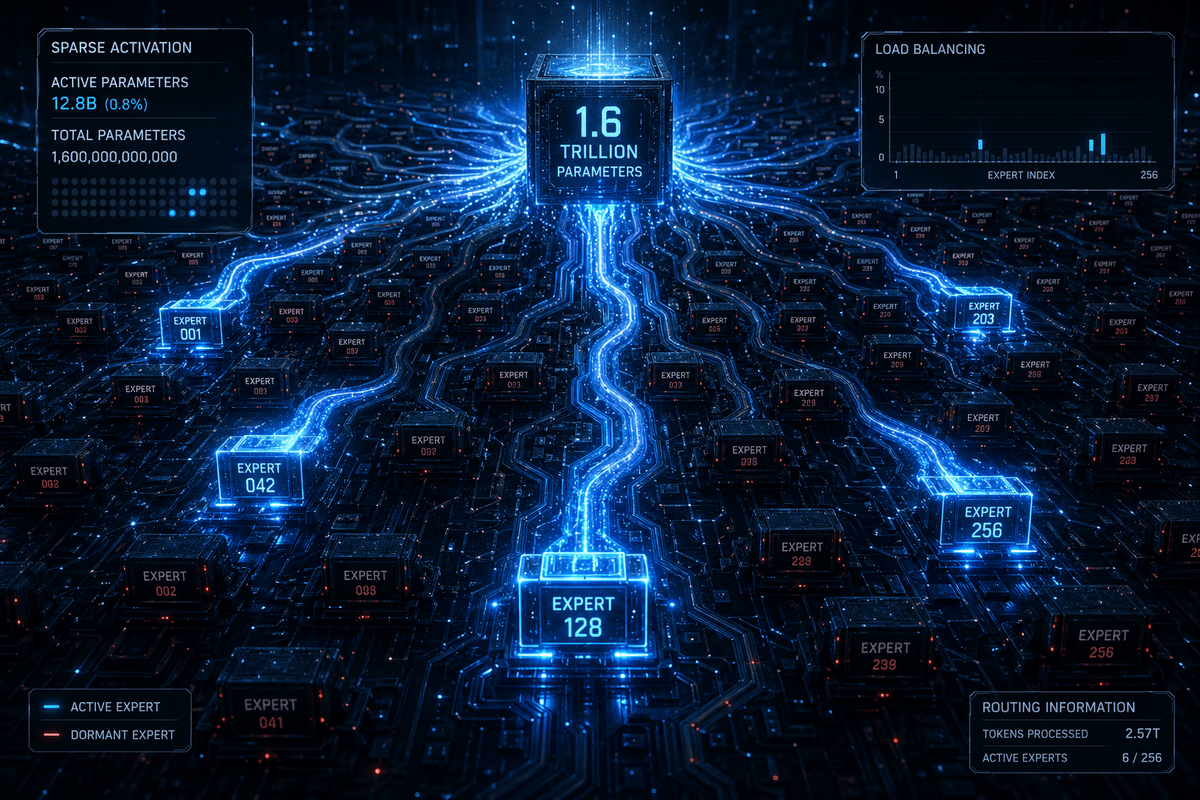
介绍 DeepSeek V4 Pro 的混合专家架构、上下文和 MIT 许可,并结合公开评测与定价,讨论部署和使用时需要考虑的条件。
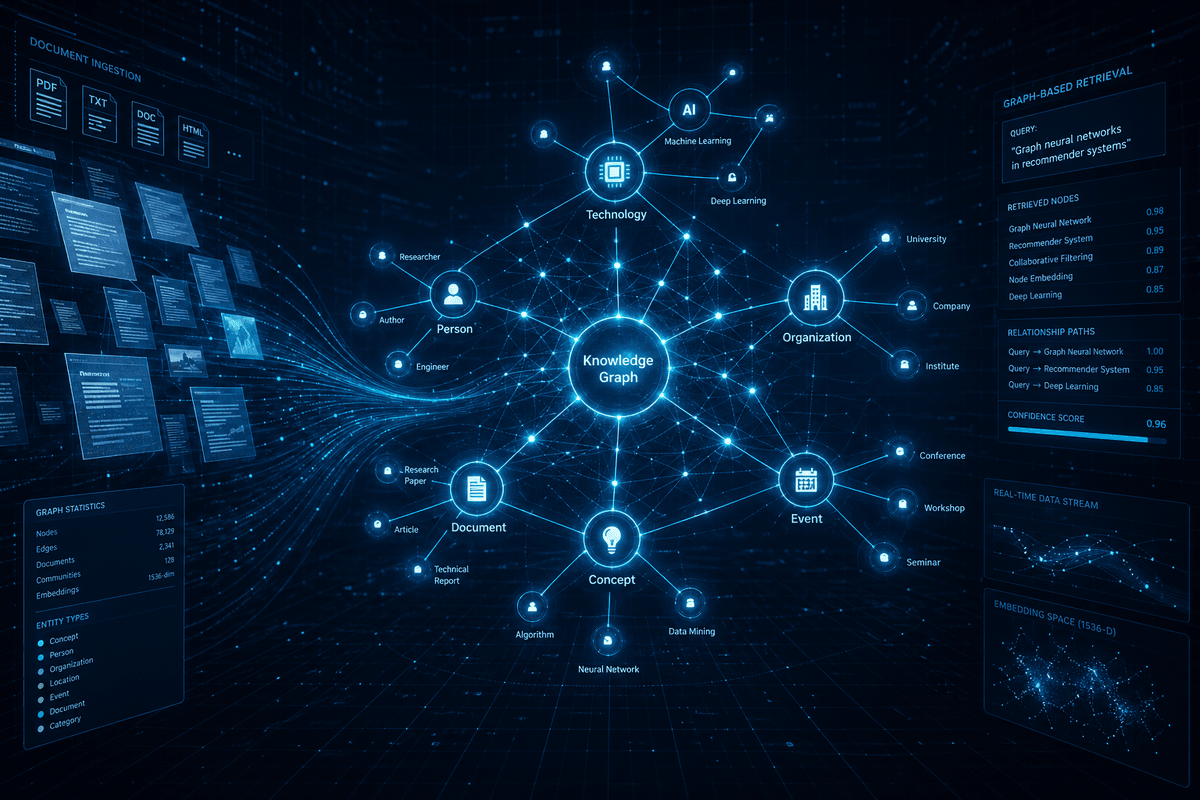
介绍 LightRAG 的图谱索引和双层检索,对照论文中的评测方法,讨论它适合处理的问题,以及构建和维护索引的开销。
整理 GPT-5.5 的官方评测数据,与 Kimi K2.6、GLM-5.1 和 Qwen 3.6 Plus 的公开结果对照,并说明分数比较的限制。
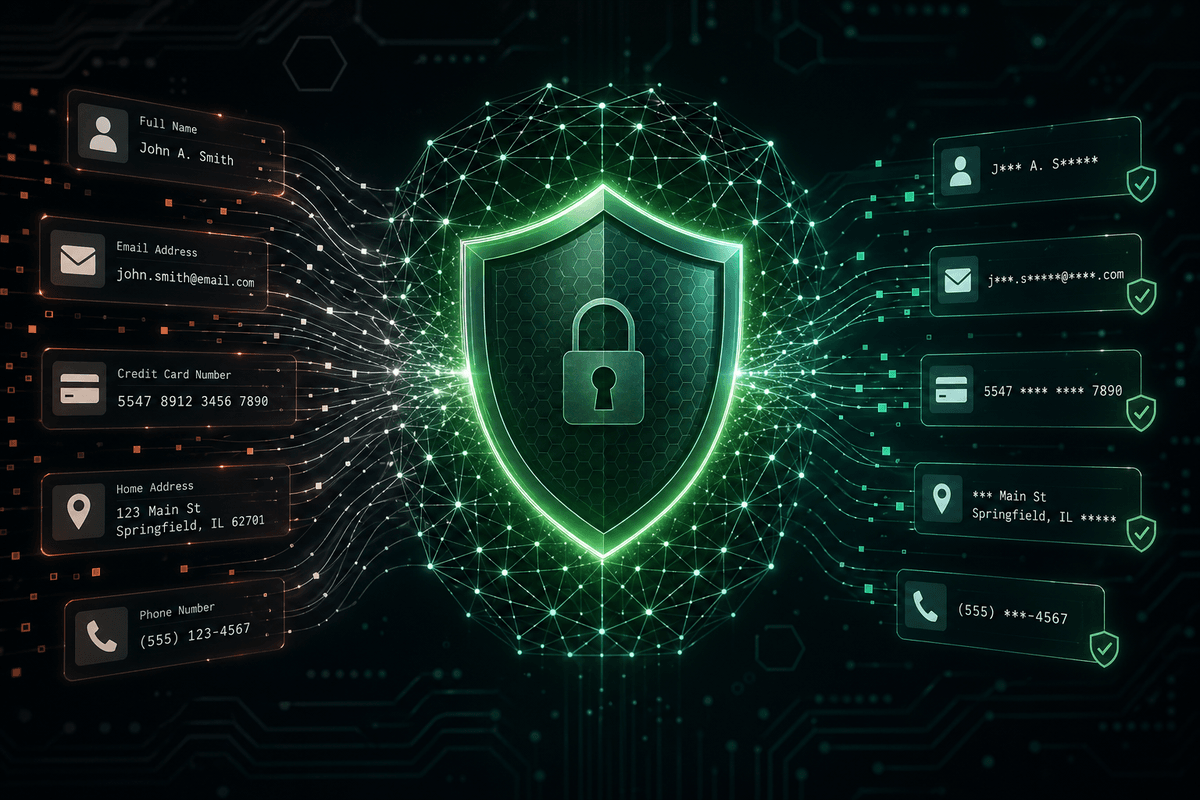
介绍 Privacy Filter 的个人信息识别、脱敏方式和本地运行条件,并说明官方评测的结果与局限。
没有找到匹配的文章。试试更短的关键词,或返回全部文章。
全部文章 →复制下方地址,添加到常用的 RSS 阅读器。
将上方地址添加到 RSS 阅读器,即可获取新文章。