DeepSeek V4 的架构、开源许可和使用成本
介绍 DeepSeek V4 Pro 的混合专家架构、上下文和 MIT 许可,并结合公开评测与定价,讨论部署和使用时需要考虑的条件。
2026年4月24日,DeepSeek 发布了 V4 系列模型。这一次,它带来的不只是更大的参数量,而是一整套让西方 AI 实验室重新审视自己定价策略的架构设计。
DeepSeek V4 是什么
1. 两个版本,两种定位
V4 系列包含两个模型:
- V4-Pro:1.6万亿总参数,每次推理激活490亿参数,旗舰级推理能力
- V4-Flash:2840亿总参数,每次推理激活130亿参数,成本优化型
两者都支持 100万 token 上下文窗口,输出上限384K token,且都使用 MIT 许可证开源,权重托管在 HuggingFace。
2. MoE 不是噱头,而是工程选择
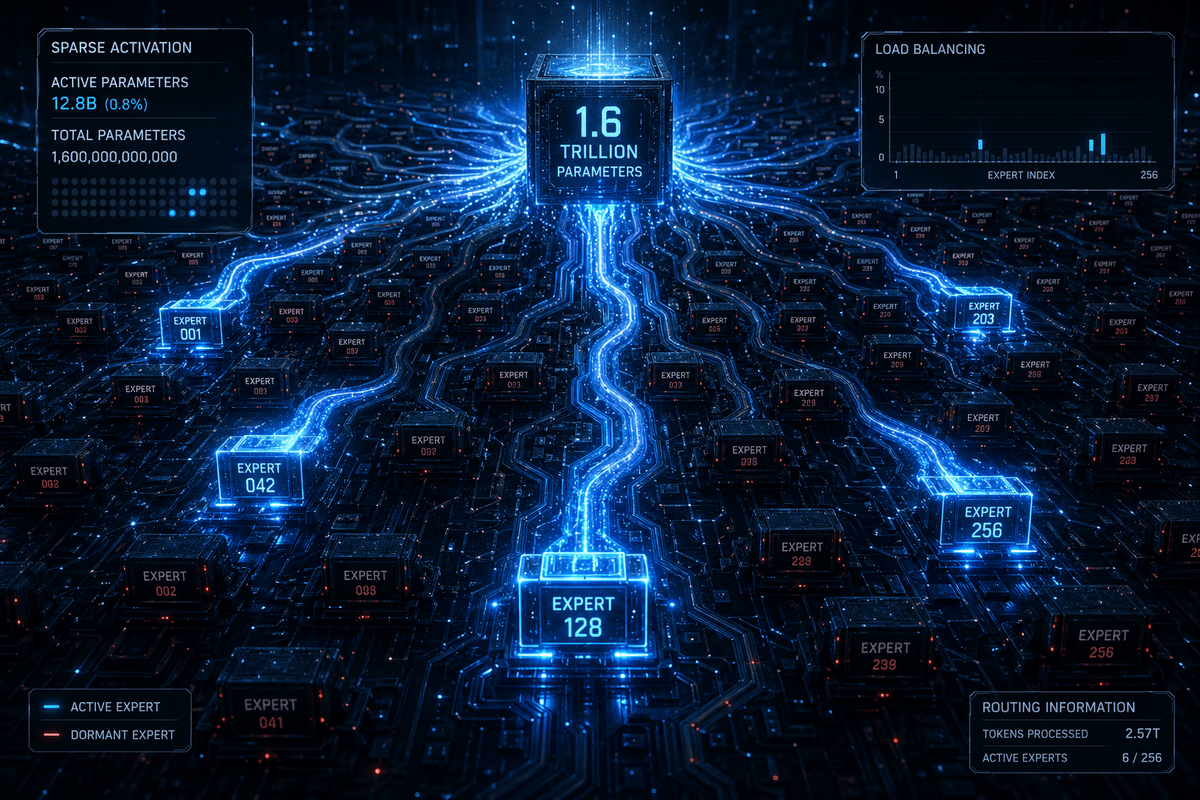
DeepSeek V4 采用 Mixture-of-Experts (MoE) 架构。简单来说:模型有1.6万亿个参数,但每次处理一个 token 时,只激活其中约3%(49B)的专家子网络。这就像一个拥有1000名专家的公司,每个项目只抽调最相关的30人参与。
这种设计的直接后果是:推理成本对标一个490亿参数的密集模型,但能力接近1.6万亿参数的密集模型。 API 定价约为 $0.10-$0.30 / 百万 token,大致是 GPT-4 的 1/50。
3. 混合注意力:1M 上下文的工程解法
100万 token 上下文不是营销数字。DeepSeek 引入了两层注意力机制的组合:
- CSA (Compressed Sparse Attention):将每 m 个 token 的 KV cache 压缩为单个条目,查询 token 只关注 top-k 压缩条目。这提供了精确的局部上下文检索。
- HCA (Heavily Compressed Attention):以128倍压缩率进行更激进的压缩,然后在压缩表示上执行密集注意力。这提供了廉价的全局上下文感知。
CSA 和 HCA 在网络中交替出现——模型在专注检索和广角感知之间切换。在100万 token 场景下,V4-Pro 只需要 V3.2 的 27% FLOPs 和 10% KV cache。
4. 双模式推理:Think / Non-Think
V4 在 API 层面提供两种模式:
- Think 模式:多步推理,8-15秒 deliberation,适合复杂分析和 agentic 工作流
- Non-Think 模式:2秒内响应,适合内容生成、摘要、数据提取
这比之前的”Chain of Thought” prompting 更可控,开发者可以根据场景明确选择推理深度。
DeepSeek V4 不是什么
1. 它不是又一个”GPT 杀手”
不要把它简单理解为”中国模型超越了美国模型”。DeepSeek 的竞争力不是在某一个 benchmark 上比 GPT-5 高几个点,而是在 相同能力水平下把成本降低了一个数量级。这是商业模式的差异,不是单纯的技术竞赛。
2. 它不是密集模型的简单放大
1.6万亿参数听起来吓人,但这不是”大力出奇迹”。如果把它当成一个1.6T的密集模型来部署,你会破产。V4 的价值在于证明了 稀疏激活 + 高效路由 可以在不牺牲能力的前提下,把万亿参数模型的推理成本压缩到可接受范围。
3. 它不是 RAG 的终结者
100万 token 上下文确实可以一次性吞入整个代码库或长篇文档,但这不意味着 RAG 会消失。CSA/HCA 本身就是对注意力机制的”检索增强”——它在内部分层选择关注哪些 token。RAG 从外部检索变成了内部路由,形态变了,但问题本质没变。
4. 它不是政府补贴的产物
V4 运行在华为昇腾芯片上,训练成本远低于西方同类模型。这不是因为补贴,而是因为 MoE 架构 + FP8 训练 + 算法-硬件协同设计 genuinely 降低了计算需求。DeepSeek-V3 的全量训练只用了278.8万 H800 GPU 小时,且全程没有不可逆的损失尖峰或回滚。
我们能从 DeepSeek V4 学到什么
1. 架构创新比算力堆砌更有价值
当 OpenAI 和 Google 在买更多 GPU 时,DeepSeek 在做三件事:
- 优化 attention:让长上下文不再是算力黑洞
- 改进优化器:从 AdamW 切换到 Muon,加速收敛并提升万亿参数训练的稳定性
- 设计路由:让模型学会”哪些专家处理哪些 token”
这三件事都不需要更多 GPU,但需要更深入的系统级思考。
2. 开源不是慈善,是商业策略
MIT 许可证 + HuggingFace 权重 + 极低 API 定价,这套组合拳的目的不是”做好事”,而是 快速占领开发者心智。当 V4 成为默认选择时,围绕它的工具链、云服务、企业定制就会形成生态。开源在这里是获客手段,不是终点。
3. “够用就好”的推理哲学
V4-Flash 只有130亿激活参数,但在大多数生产场景中完全够用。这揭示了一个被忽视的趋势:推理成本正在取代模型能力,成为 AI 产品化的最大瓶颈。当 V4-Flash 能以 GPT-4 1/50 的价格完成80%的任务时,剩下的20%能力溢价是否值得,就成了一个商业问题。
4. 注意力机制还可以继续进化
CSA + HCA 的混合设计说明,Transformer 的注意力机制远未到头。从 dense attention → sparse attention → compressed attention,每一次压缩都在挑战”注意力必须是二次复杂度”的假设。如果你在做 AI 基础设施,这是一个值得深入的方向。
写在最后
DeepSeek V4 最可怕的地方不是它的 benchmark 分数,而是它证明了 前沿 AI 能力可以以开源 + 低成本的方式交付。当 GPT-5.5 Pro 输出定价 $30/百万 token 时,V4-Pro 输出只卖 $3.48——不到其 1/8。而 V4-Flash 输入仅 $0.14,约为 GPT-5.5 Pro 输入 $15 的 1/100。这个价差不是折扣,是结构性差异。
西方 AI 巨头现在面临一个选择:继续走闭源高溢价路线,还是被迫降价参与开源竞争?无论哪种选择,DeepSeek V4 都已经改变了游戏规则。
参考:DeepSeek-V4-Pro Technical Report, HuggingFace DeepSeek-V4-Pro, DataCamp DeepSeek V4 Analysis, MorphLLM DeepSeek V4 Guide
DeepSeek V4-Pro 永久降价,第三方托管服务面临利润压力
DeepSeek 将 V4-Pro 的促销价格改为长期定价。对照官方 API 与第三方托管服务的成本,分析降价怎样影响服务商的报价和收入。
Grok 4.3 与 DeepSeek、MiniMax、MiMo 的性能和价格比较
对照 Grok 4.3、DeepSeek V4 Flash、MiniMax M2.7 和 MiMo 2.5 的公开资料,比较模型规格、评测结果和 API 费用,说明评测口径的差别。
小米 MiMo V2.5 Pro:长时间编程任务中的表现
结合小米公布的编译器、视频编辑器和芯片设计任务,分析 MiMo V2.5 Pro 在长任务中的工具调用、上下文管理和可靠性。
通过 RSS 订阅新文章
复制下方地址,添加到常用的 RSS 阅读器。
将上方地址添加到 RSS 阅读器,即可获取新文章。